Customer Lake: transformando dados de clientes em inteligência, personalização e crescimento
Como a integração de dados, a visão Customer 360 e a inteligência artificial ajudam empresas a conhecer melhor seus clientes e a transformar informações dispersas em decisões de negócio.
As empresas acumulam dados sobre seus clientes em cada momento da jornada. Uma compra no e-commerce, uma interação com o atendimento, uma visita ao aplicativo, uma proposta comercial e uma solicitação de suporte revelam aspectos importantes do relacionamento de uma pessoa com a marca.
O problema é que esses dados raramente estão conectados.
O CRM reúne o histórico comercial, as plataformas de marketing registram campanhas e interações, os sistemas transacionais armazenam compras e pagamentos, e as ferramentas digitais acompanham a navegação. Cada ambiente conta uma parte da história, mas nenhum deles, isoladamente, oferece uma visão completa o bastante para apoiar decisões em toda a empresa.
Essa fragmentação gera abordagens comerciais sem contexto, campanhas direcionadas ao público errado, oportunidades de retenção perdidas e indicadores que não batem entre departamentos.
É nesse contexto que o conceito de Customer Lake ganha relevância: uma abordagem para integrar, organizar e entregar dados de clientes em uma arquitetura que atende, ao mesmo tempo, analytics, personalização, machine learning e aplicações de negócio.
Com uma base confiável, as empresas passam a compreender melhor seus públicos, antecipar comportamentos e oferecer experiências mais relevantes ao longo de todo o relacionamento.
O que é Customer Lake?
Customer Lake é uma abordagem de arquitetura de dados voltada à integração e ao gerenciamento de dados de clientes vindos de diferentes sistemas e canais.
A proposta é reunir dados transacionais, cadastrais, comportamentais e de relacionamento em uma estrutura que forme uma visão consistente do cliente e sirva a diferentes aplicações.
O conceito é implementado sobre arquiteturas modernas de dados, como Data Lakes e Lakehouses, combinando engenharia de dados, governança, processamento analítico e inteligência artificial.
Na prática, um Customer Lake integra dados provenientes de:
- CRM e sistemas comerciais;
- ERP, faturamento e histórico de compras;
- Sites, aplicativos e plataformas de e-commerce;
- Campanhas e ferramentas de automação de marketing;
- Atendimento, suporte e relacionamento;
- Programas de fidelidade;
- Eventos digitais e interações com produtos e serviços.
O objetivo é que esses dados sejam relacionados e interpretados em conjunto, respeitando as regras de acesso e as finalidades autorizadas para seu tratamento.
Por exemplo: um cliente com compras recorrentes abriu recentemente um chamado de suporte e reduziu o uso de um serviço. Vistos separadamente, esses sinais passam despercebidos; analisados em conjunto, indicam risco de cancelamento e orientam uma ação de retenção antes que ele aconteça.
É importante diferenciar o conceito arquitetural de Customer Lake do produto CustomerLake, anunciado pela Databricks em 16 de junho de 2026, no Data + AI Summit. A solução incorpora funcionalidades de CDP, resolução de identidade, segmentação, ativação e agentes de IA diretamente ao ambiente Databricks.
Também vale situar o termo no mercado: fora do produto da Databricks, essa mesma abordagem costuma ser chamada de CDP composable (ou warehouse-native), ou simplesmente de Customer 360 sobre o lakehouse. Neste artigo, usamos “Customer Lake” para a arquitetura de forma ampla e “CustomerLake” apenas para o produto, e mostramos como plataformas modernas apoiam sua implementação.
Customer Lake, CRM, CDP e Data Lake: qual é a diferença?
Embora esses conceitos estejam relacionados, cada um desempenha uma função diferente dentro da estratégia de dados.
O CRM concentra os dados necessários à gestão do relacionamento comercial e do atendimento. Ele acompanha oportunidades, contatos, negociações e interações, mas não foi projetado para reunir todos os eventos comportamentais, transacionais e operacionais produzidos pela organização.
Uma Customer Data Platform (CDP) é voltada à integração de dados de clientes, à unificação de perfis, à segmentação e à ativação desses perfis em campanhas e personalização. Seu foco principal é o marketing.
O Data Lake, por sua vez, é uma estrutura de armazenamento capaz de receber dados de diferentes tipos: estruturados, semiestruturados e não estruturados.
Já o Customer Lake aplica a arquitetura de dados especificamente ao cliente. A diferença em relação à CDP está no escopo: além de alimentar o marketing, a mesma base governada atende BI, modelos de machine learning, atendimento, vendas e processos operacionais, sem copiar os dados para um sistema à parte.
| Conceito | Principal finalidade |
|---|---|
| CRM | Gerenciar interações, contatos e processos de relacionamento comercial |
| CDP | Unificar perfis e ativá-los em campanhas e canais de marketing |
| Data Lake | Armazenar dados brutos de qualquer tipo, sem foco em uma entidade específica |
| Customer Lake | Manter uma base governada e integrada do cliente, que atende analytics, IA, marketing e processos operacionais |
Essas tecnologias não competem entre si. O CRM alimenta o Customer Lake, e uma CDP pode consumir dados dessa arquitetura para construir segmentos e ativar experiências em diferentes canais.
A combinação ideal depende das capacidades que a empresa já possui, das integrações necessárias e dos problemas que precisa resolver.
Como funciona a arquitetura de um Customer Lake?
Um Customer Lake exige mais do que armazenamento centralizado. Para transformar dados dispersos em uma base confiável, a arquitetura precisa contemplar ingestão, transformação, identificação de clientes, governança e entrega dos dados.
Essas capacidades se organizam em cinco etapas sequenciais, sustentadas por uma camada transversal de governança e segurança, como mostra a Figura 2.
1. Integração e ingestão de dados
A primeira etapa conecta as fontes que armazenam dados relevantes sobre os clientes. Na Figura 2, ela aparece desdobrada em dois blocos: fontes de dados e ingestão.
Conforme os sistemas envolvidos, a ingestão ocorre por APIs, conectores, replicação de bancos de dados (CDC), arquivos ou eventos transmitidos em streaming.
A frequência de atualização deve acompanhar a necessidade de cada aplicação.
Relatórios gerenciais funcionam bem com cargas periódicas. Já casos como personalização durante uma sessão digital ou alertas para o atendimento exigem uma arquitetura de baixa latência.
Também é importante registrar a origem de cada dado, o horário da atualização e eventuais falhas de processamento, o que garante rastreabilidade e facilita auditorias.
2. Padronização e qualidade dos dados
Depois da ingestão, os dados precisam passar por processos de validação e transformação.
Uma mesma informação aparece de maneiras diferentes em cada sistema. Datas, telefones, identificadores, endereços, categorias de produtos e status comerciais costumam seguir padrões distintos.
Além disso, há registros incompletos, desatualizados ou duplicados.
Nessa etapa, são estabelecidas regras para padronizar os campos, identificar inconsistências, tratar valores ausentes e definir quais fontes devem ser consideradas em cada contexto.
O objetivo é construir uma base que permita análises consistentes, sem perder a rastreabilidade dos registros originais.
3. Resolução de identidade e construção do Customer 360
Uma das capacidades mais importantes de um Customer Lake é reconhecer quando registros de sistemas diferentes se referem ao mesmo cliente.
Esse processo é conhecido como Identity Resolution, ou resolução de identidade.
Imagine uma cliente cadastrada no CRM como “MARIA A. SOUZA”, que comprou no e-commerce com o e-mail “Maria.Souza@Email.com” e abriu um chamado no atendimento informando apenas “maria souza” e o telefone, sem e-mail.
Sem mecanismos adequados de identificação, esses registros seriam tratados como três clientes diferentes.
A resolução de identidade aplica regras e técnicas de correspondência para relacionar registros. Métodos determinísticos usam identificadores conhecidos, como e-mail, telefone ou documento; métodos probabilísticos comparam diversos atributos para estimar a probabilidade de que dois registros sejam da mesma pessoa. No exemplo, e-mail e telefone coincidentes, somados a variações do mesmo nome, permitem vincular os três registros com segurança.
O resultado é a visão Customer 360, na qual dados de diferentes origens passam a estar relacionados a uma mesma identidade ou entidade de negócio.
Isso não exige consolidar tudo em um único registro físico. A visão unificada pode ser construída por meio de identificadores, relacionamentos e regras que preservam os registros originais.
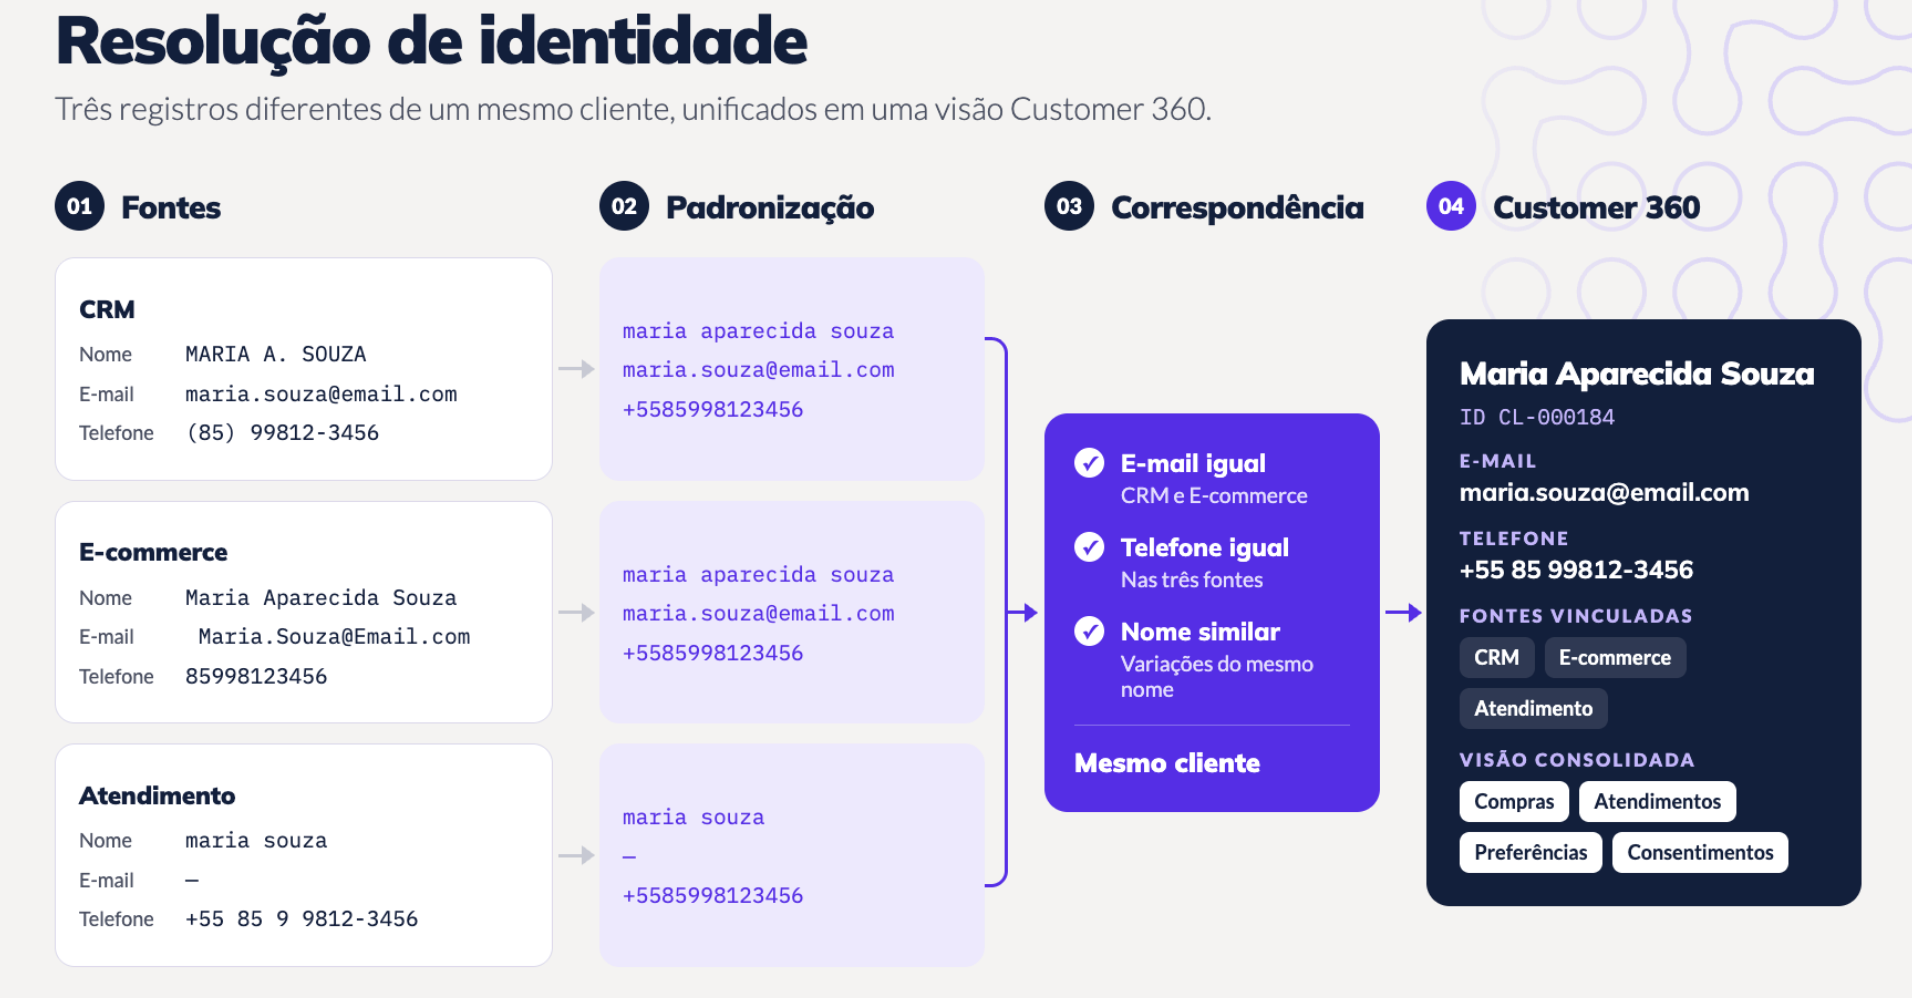
Figura 1. Diagrama de resolução de identidade. Mostra três registros diferentes de uma mesma cliente (CRM, e-commerce e atendimento), que passam por padronização e correspondência até formar uma visão Customer 360.
Camada transversal: governança e segurança
Antes das duas últimas etapas, vale detalhar a camada que atravessa todas elas. A integração de dados de clientes exige uma governança que defina como esses dados serão usados, compartilhados e protegidos.
Essa camada envolve controle de acesso, catalogação, classificação de dados, rastreabilidade (linhagem), auditoria e políticas de retenção.
Também é necessário estabelecer responsabilidades entre as áreas que produzem, administram e consomem os dados.
Por exemplo, a equipe de marketing precisa acessar segmentos e indicadores comportamentais, mas não necessariamente dados pessoais identificáveis ou informações financeiras detalhadas.
A arquitetura deve garantir que cada aplicação acesse apenas os dados necessários à sua finalidade, de acordo com as políticas corporativas e os requisitos legais. Os aspectos ligados à LGPD são detalhados mais adiante neste artigo.
4. Enriquecimento analítico e inteligência artificial
Com os dados integrados e organizados, a empresa vai além do histórico descritivo.
Modelos de machine learning identificam padrões, classificam comportamentos e estimam resultados futuros.
Entre as aplicações mais comuns estão propensão de compra, previsão de churn, recomendação de produtos e estimativa do valor do cliente ao longo do tempo (CLV, customer lifetime value).
A IA generativa também entra nesse processo, apoiando a consulta e a interpretação dos dados, desde que haja mecanismos adequados de segurança, contexto e avaliação das respostas.
Todas essas aplicações dependem diretamente da qualidade dos dados. Um modelo alimentado por registros inconsistentes produz recomendações ruins, por mais avançada que seja a tecnologia.
5. Disponibilização e ativação dos dados
A última etapa entrega os dados às equipes e aplicações que vão usá-los.
Eles alimentam dashboards, ferramentas de BI, plataformas de marketing, sistemas comerciais, aplicações de atendimento e modelos de IA, por consulta direta, APIs ou reverse ETL.
É nessa etapa que o Customer Lake deixa de funcionar apenas como uma estrutura de armazenamento e passa a apoiar processos de negócio.
A ativação precisa considerar os requisitos de atualização de cada canal, as permissões de uso e os mecanismos para medir os resultados das ações.
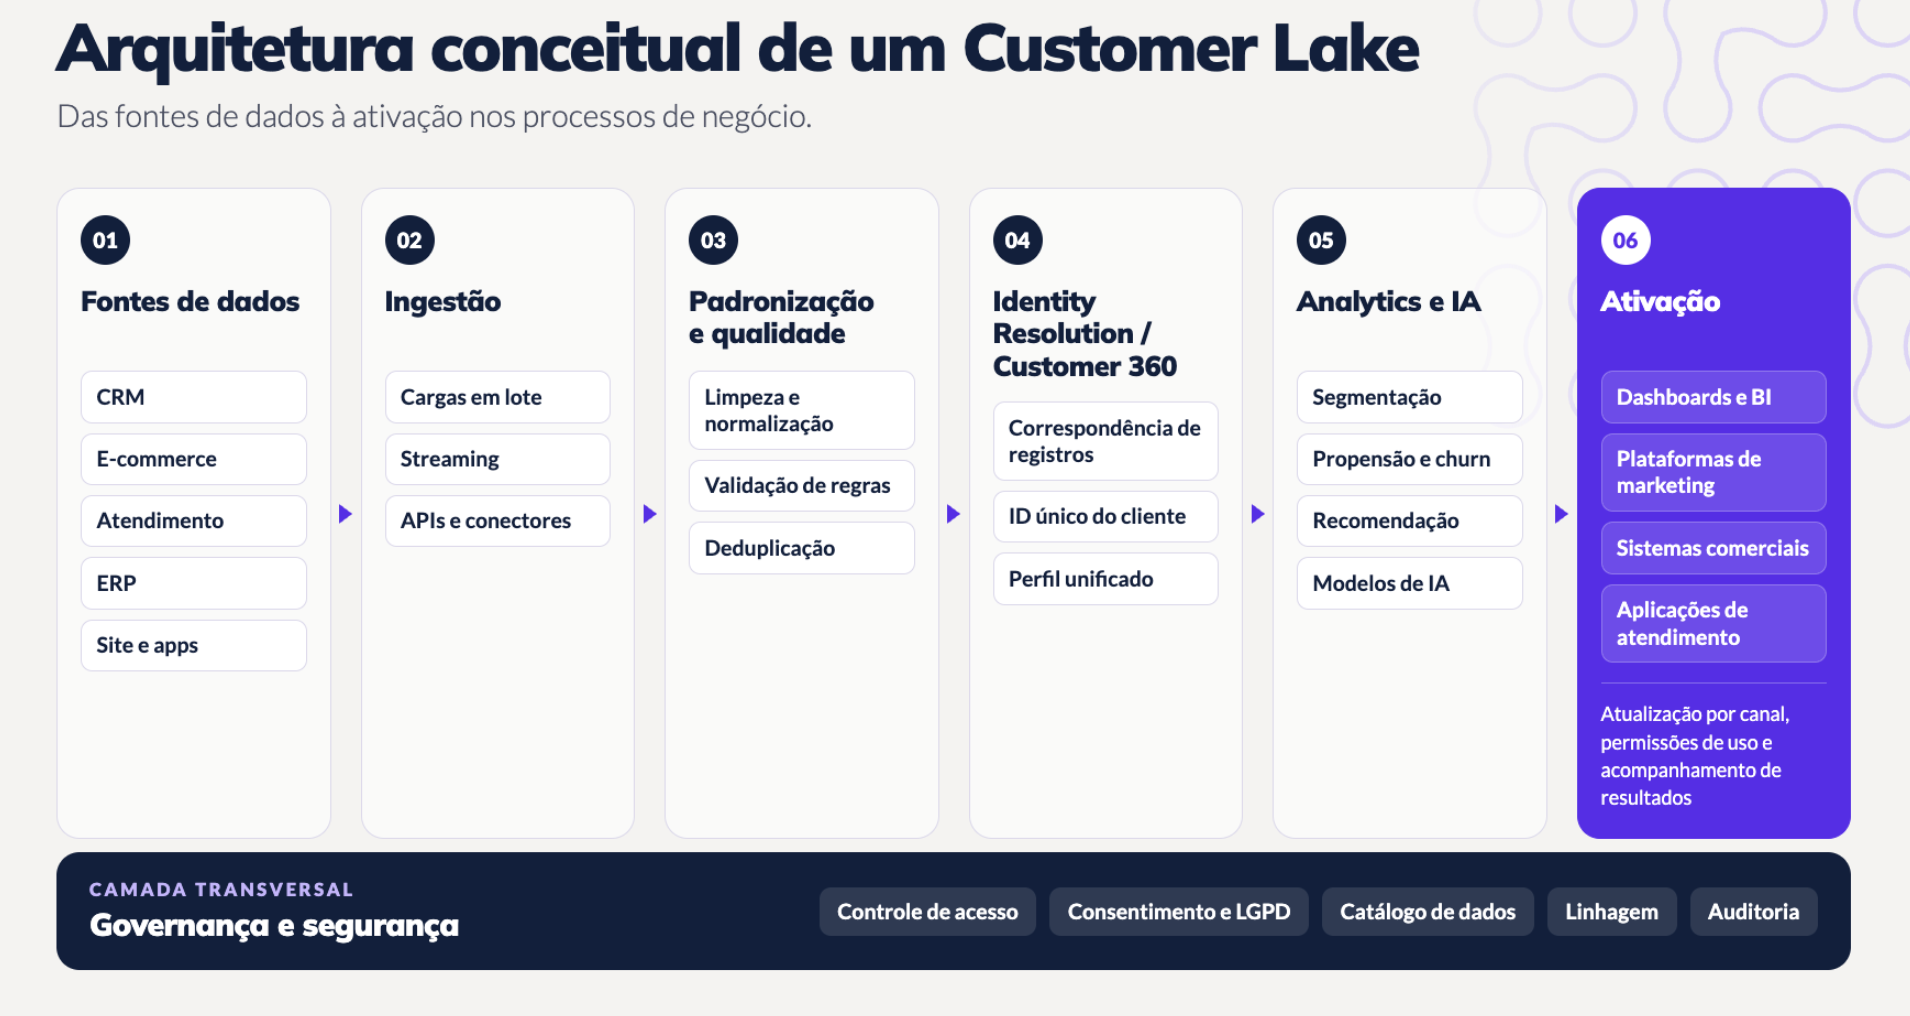
Figura 2. Arquitetura conceitual de um Customer Lake. O fluxo parte das fontes de dados e passa por ingestão, padronização e qualidade, Identity Resolution/Customer 360 e analytics e IA até a ativação. Governança e segurança formam uma camada transversal a toda a arquitetura.
Como o Customer Lake transforma dados em personalização?
A personalização depende da capacidade de compreender o contexto de cada interação.
Uma empresa pode conhecer as preferências de um cliente, mas, se esses dados estiverem presos a um único canal, não conseguirão orientar a experiência como um todo.
Com uma arquitetura integrada, diferentes sinais são analisados em conjunto e sustentam decisões mais contextualizadas.
Considere um varejista que identifica clientes com interesse recorrente em uma categoria de produtos. Ao cruzar esse comportamento com o histórico de compras, a disponibilidade de estoque e as interações recentes, ele oferece recomendações mais relevantes e evita sugerir itens indisponíveis.
Da mesma forma, uma empresa de serviços cruza dados de contratação, uso e atendimento para identificar os clientes que precisam de acompanhamento específico.
O Customer Lake oferece a estrutura para essas aplicações, mas a personalização efetiva também depende de regras de negócio, modelos analíticos, integração com os canais e avaliação contínua dos resultados.
Segmentação dinâmica de clientes
A segmentação tradicional costuma usar critérios fixos, como localização, faixa de consumo ou histórico de compras.
Com dados integrados, os segmentos incorporam sinais comportamentais e contextuais e se atualizam conforme a jornada do cliente muda.
Assim, surgem grupos mais específicos, como clientes com alto potencial de recompra, usuários que reduziram a frequência de uso ou consumidores interessados em categorias específicas.
Recomendações personalizadas
Modelos analíticos combinam histórico de compras, preferências e padrões de comportamento para alimentar sistemas de recomendação.
Essas recomendações chegam a sites, aplicativos, campanhas e canais de relacionamento, respeitando os dados e as permissões disponíveis em cada contexto.
Prevenção de churn
Churn é a perda de clientes em um determinado período.
Ao integrar dados de uso, histórico comercial, atendimento e comportamento, a empresa desenvolve modelos que estimam a propensão ao cancelamento ou à redução do relacionamento.
Com isso, as equipes priorizam os clientes em risco e direcionam as iniciativas de retenção, medindo o resultado de cada ação.
Próxima melhor ação (Next Best Action)
Outra aplicação é identificar a abordagem mais adequada para cada momento da jornada.
Em vez de enviar a mesma comunicação para todos, a empresa considera relacionamento anterior, interações recentes, produtos contratados e objetivos comerciais.
A próxima melhor ação pode ser uma recomendação, uma oferta, um contato de suporte ou até a decisão de não abordar o cliente naquele momento.
Quais áreas se beneficiam de um Customer Lake?
Embora o conceito seja associado principalmente ao marketing, seus benefícios se estendem a toda a organização.
Marketing: segmentação de públicos, personalização de campanhas, análise da jornada e mensuração de iniciativas.
Vendas: identificação de oportunidades, enriquecimento do contexto comercial e priorização de relacionamentos.
Atendimento: acesso ao histórico completo do cliente e continuidade do atendimento entre canais.
Produtos e serviços: análise de comportamento, uso de funcionalidades e identificação de oportunidades de evolução.
Gestão e estratégia: acompanhamento de indicadores de aquisição, retenção, receita e relacionamento.
O uso compartilhado da mesma base também reduz divergências entre indicadores produzidos por diferentes departamentos.
Quando marketing, vendas e atendimento usam definições diferentes de cliente ativo, recorrência ou cancelamento, por exemplo, cada área chega a um número diferente para o mesmo período.
Uma arquitetura bem estruturada estabelece métricas e regras de negócio únicas, sem deixar de atender às necessidades específicas de cada área.
Customer Lake e IA: como evoluir de análises descritivas para decisões inteligentes?
A integração de dados de clientes cria condições para desenvolver aplicações analíticas mais avançadas.
No primeiro estágio, o Customer Lake responde a perguntas descritivas: quantos clientes compraram, quais canais geraram mais interações e como cada segmento se comportou.
No segundo, modelos preditivos passam a estimar comportamentos futuros.
No terceiro, a IA generativa amplia essas possibilidades, criando novas formas de interagir com os dados e apoiando processos de análise e operação.
Uma equipe comercial, por exemplo, consulta segmentos, indicadores ou tendências de relacionamento em linguagem natural, por meio de uma interface conversacional conectada a dados governados.
Agentes de IA vão além e participam de fluxos de trabalho mais complexos, combinando consultas, regras e ferramentas para executar atividades previamente definidas.
O uso de IA sobre dados de clientes, porém, exige atenção especial a controles de acesso, qualidade das fontes, avaliação dos resultados e limites de atuação de cada aplicação.
A integração entre Customer Lake e IA deve ser construída sobre uma base confiável, com responsabilidades e mecanismos de supervisão adequados.
Como a Databricks pode apoiar uma arquitetura Customer Lake?
Um Customer Lake pode ser construído sobre diferentes tecnologias, conforme os requisitos e o ambiente existente. A Databricks se destaca por reunir todas as etapas dessa arquitetura em uma mesma plataforma.
No ecossistema Databricks, a arquitetura Lakehouse integra engenharia de dados, analytics, governança e inteligência artificial em uma plataforma compartilhada.
O Delta Lake gerencia tabelas com transações ACID e histórico de versões, enquanto o Unity Catalog centraliza a governança de dados e de ativos de IA, com controle de acesso, linhagem, auditoria, filtros de linha e máscaras de coluna. São esses recursos que viabilizam, por exemplo, o cenário em que o marketing acessa segmentos sem ver dados pessoais identificáveis.
Na ingestão e na transformação, o Lakeflow oferece conectores e pipelines declarativos, em lote ou em streaming, e a Lakehouse Federation permite consultar fontes externas sem replicá-las. As capacidades de machine learning e IA da plataforma, por sua vez, sustentam modelos de propensão, churn e recomendação sobre a base integrada.
Além desses componentes, em 16 de junho de 2026, a Databricks anunciou o CustomerLake, uma Customer Data Platform agêntica nativa da plataforma.
A proposta do produto é aproximar a base governada de dados das atividades de marketing e relacionamento, incorporando capacidades como:
- Construção de perfis Customer 360;
- Resolução de identidade;
- Segmentação de públicos;
- Ativação de dados em ferramentas de marketing e relacionamento;
- Personalização apoiada por inteligência artificial;
- Agentes voltados à construção de perfis e campanhas.
No anúncio, o CustomerLake foi apresentado em Private Preview. Por isso, a disponibilidade de cada funcionalidade deve ser confirmada conforme o estágio de lançamento, a região e as condições comerciais.
Para empresas que já usam Databricks, essa evolução encurta o caminho entre a arquitetura corporativa de dados e as aplicações de relacionamento com clientes, sem a necessidade de copiar dados para uma CDP separada.
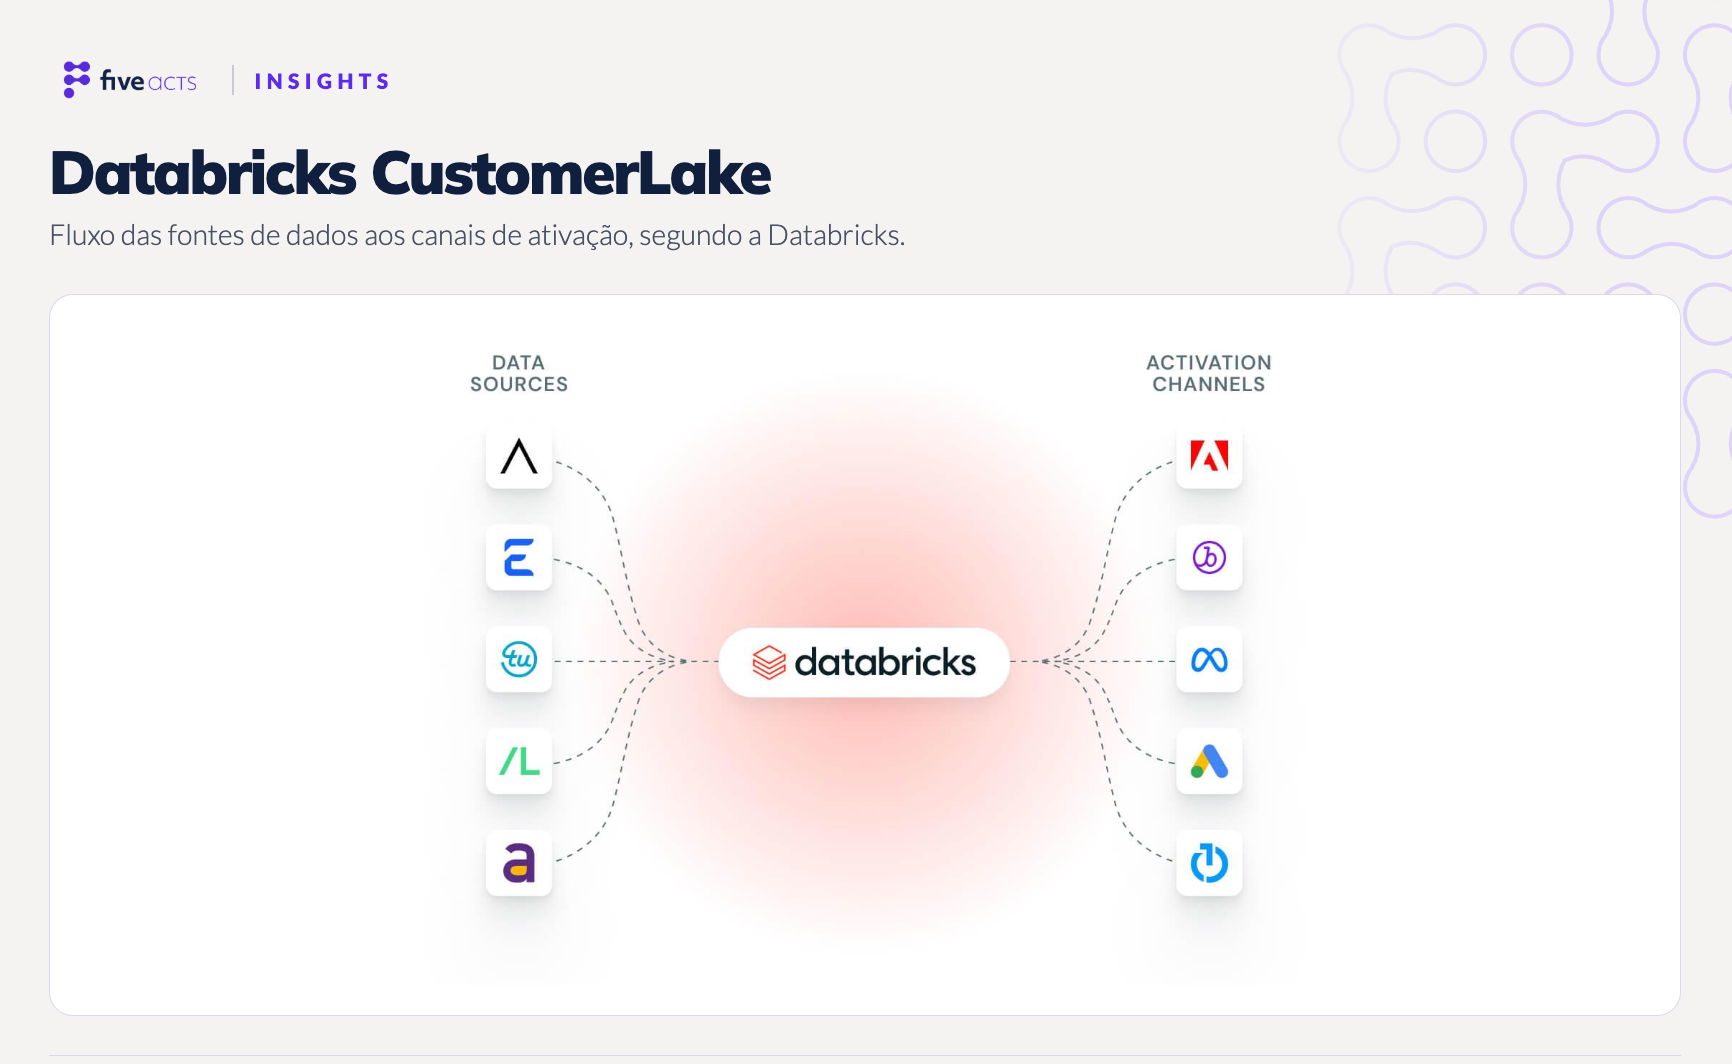
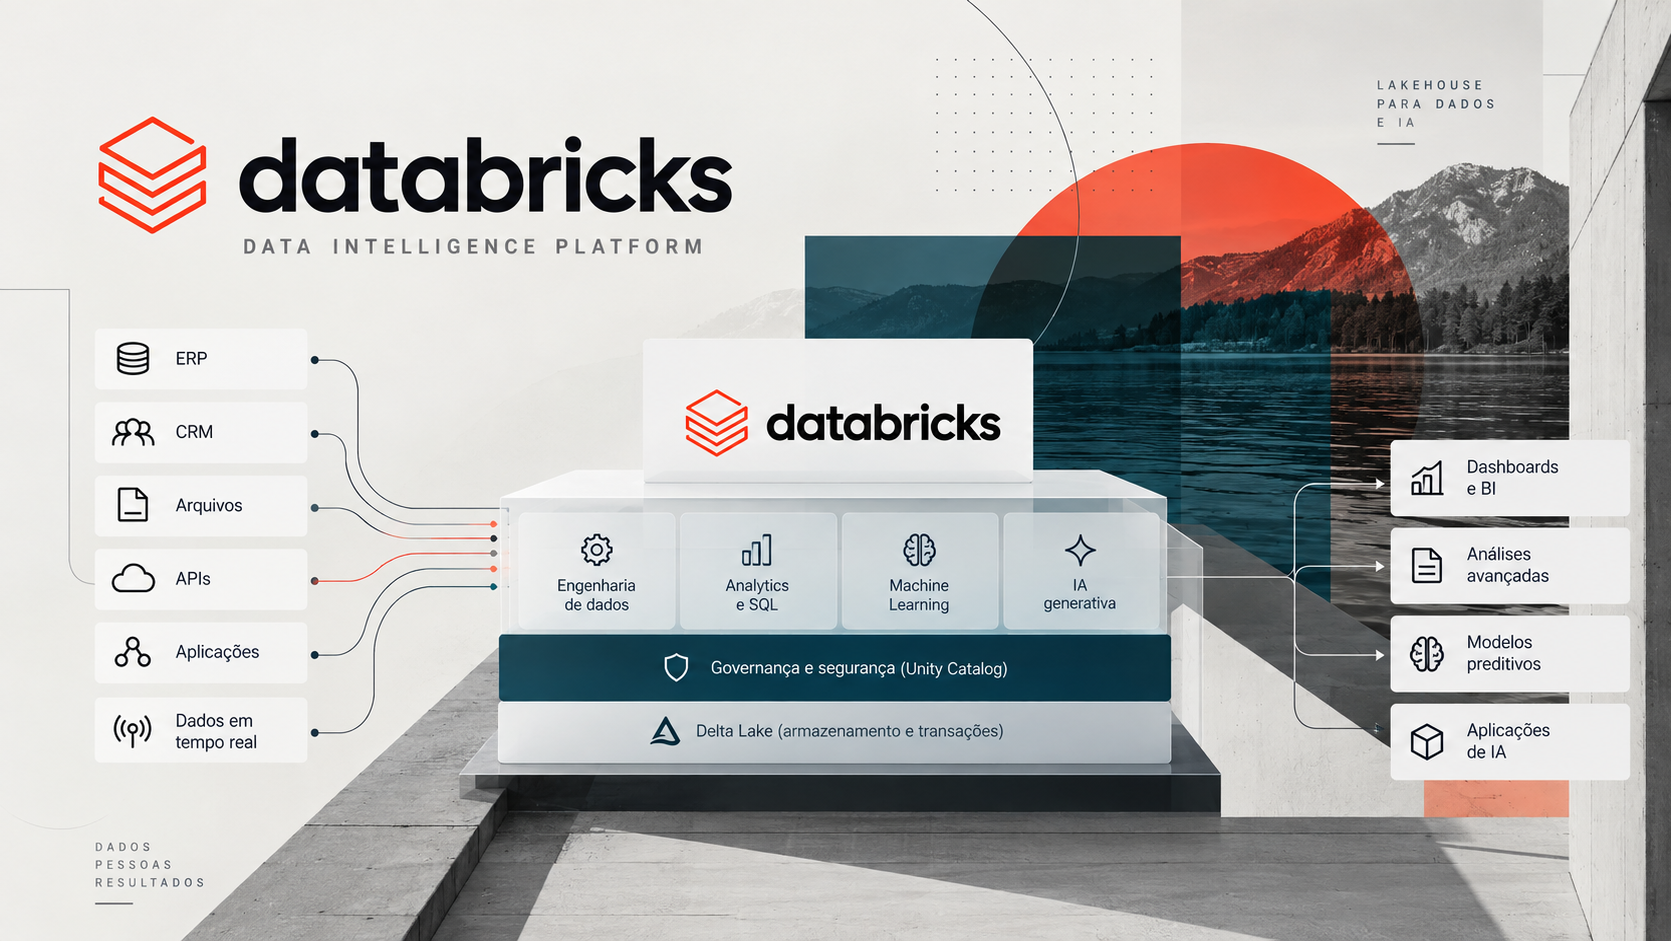
Figura 3. Diagrama oficial do Databricks CustomerLake, que apresenta o fluxo das fontes de dados até os canais de ativação. Fonte: Databricks.
LGPD e governança: como usar dados de clientes com responsabilidade?
A construção de uma visão integrada do cliente envolve o tratamento de informações que podem identificar pessoas direta ou indiretamente.
Por isso, os requisitos de privacidade e proteção de dados devem fazer parte da arquitetura desde o planejamento.
No Brasil, a Lei Geral de Proteção de Dados Pessoais (LGPD) estabelece princípios e condições para o tratamento de dados pessoais.
Entre os princípios que precisam ser considerados estão finalidade, adequação, necessidade, transparência, segurança e o respeito aos direitos dos titulares.
Na implementação de um Customer Lake, esses requisitos devem ser traduzidos em decisões técnicas e operacionais.
Isso envolve definir quais dados serão integrados, para quais finalidades serão usados, quem poderá acessá-los e por quanto tempo serão mantidos.
Também é necessário estabelecer processos para atender às solicitações dos titulares e controlar o compartilhamento de dados entre sistemas e aplicações.
Um ponto crítico: a integração técnica entre duas fontes não representa, por si só, autorização para usar todos os seus dados para qualquer finalidade. Cada tratamento precisa ser avaliado conforme sua base legal e seu contexto.
A governança deve acompanhar todo o ciclo de vida dos dados, desde a ingestão até o consumo por aplicações analíticas e de inteligência artificial.
Como implementar um Customer Lake na sua empresa?
A implementação deve começar pela identificação dos problemas de negócio que a arquitetura precisa resolver.
Centralizar dados sem definir antes como serão usados resulta em uma estrutura tecnicamente complexa, mas pouco aproveitada pelas áreas que tomam decisões.
Um caminho consistente envolve cinco frentes de trabalho.
1. Definir os casos de uso prioritários
A empresa deve definir os resultados que pretende alcançar, como melhorar a segmentação, reduzir o churn, integrar dados de atendimento ou oferecer uma visão Customer 360 para diferentes departamentos. Um bom primeiro caso de uso combina impacto mensurável, um patrocinador de negócio e fontes de dados acessíveis.
Esses objetivos determinam quais fontes precisam ser integradas e quais requisitos vão orientar o projeto.
2. Mapear as fontes e avaliar a qualidade dos dados
É necessário entender onde os dados estão armazenados, como são atualizados, quais identificadores usam e quais inconsistências precisam ser tratadas.
Essa análise também deve contemplar as restrições de acesso e as finalidades autorizadas para o tratamento dos dados.
3. Definir a arquitetura tecnológica
A escolha da arquitetura envolve avaliar armazenamento, processamento, ingestão, governança, integração e entrega dos dados, além de decidir o que construir sobre a plataforma existente e o que contratar como produto.
O ambiente existente deve ser considerado para evitar duplicações desnecessárias e aproveitar os investimentos tecnológicos já realizados.
4. Implementar a visão unificada do cliente
Com a base preparada, são desenvolvidas as regras de padronização, resolução de identidade e relacionamento entre registros.
É fundamental definir critérios para correspondências incertas, informações conflitantes e alterações cadastrais. Na maioria dos projetos de Customer 360, é aqui, e não na ingestão, que se concentra o maior esforço.
5. Disponibilizar os dados e acompanhar os resultados
A implementação precisa incluir a integração com os canais e aplicações que vão consumir os dados.
Também devem ser definidos indicadores para acompanhar os resultados dos casos de uso, a qualidade da base e o desempenho operacional da arquitetura.
Entre as métricas recomendadas estão a taxa de correspondência de identidades, a atualização dos perfis, a completude dos registros, o tempo para disponibilizar dados e os indicadores de negócio de cada aplicação, como retenção, conversão e receita por cliente.
A evolução deve ser incremental: começar por um caso de uso prioritário, comprovar valor e ampliar a arquitetura conforme os resultados e as necessidades da organização.
Também vale evitar armadilhas comuns: iniciar o projeto sem um dono de negócio para os dados de cliente, tentar integrar todas as fontes de uma vez, aceitar correspondências de identidade sem medir sua precisão e tratar a LGPD apenas no final, quando as decisões de arquitetura já foram tomadas.
Da visão integrada do cliente às decisões de negócio: conte com a Five Acts
Construir um Customer Lake envolve conectar diferentes fontes, estabelecer regras de governança, desenvolver pipelines confiáveis e preparar os dados para aplicações analíticas e de inteligência artificial.
Na Five Acts, apoiamos empresas nesse processo, com experiência em engenharia de dados, arquitetura Lakehouse, analytics, machine learning, IA e cloud.
Nossa atuação contempla desde o diagnóstico do ambiente e a definição da arquitetura até a implementação, integração e evolução das soluções, considerando os requisitos técnicos e os objetivos de cada organização.
Seja para construir uma visão Customer 360, modernizar a infraestrutura de dados, estruturar uma arquitetura em Databricks ou preparar informações de clientes para aplicações de IA, ajudamos sua empresa a transformar dados dispersos em uma base confiável para decisões e novas oportunidades de negócio.
Sua empresa tem informações valiosas sobre os clientes, mas ainda não consegue conectá-las e usá-las de forma integrada? Converse com os especialistas da Five Acts e conte o que sua empresa precisa resolver. Vamos ajudar a definir e implementar o caminho mais adequado.
Agende uma Demonstração da Databricks com a Five Acts
Referências
AWS: Guidance for Customer Data Platform - Arquitetura de integração, resolução de identidade, segmentação, análise e ativação.
AWS: Customer 360 - Visão integrada do cliente, personalização e análise da jornada.
AWS: Customer 360 em uma arquitetura Data Mesh - Organização e governança de dados de clientes como produto de dados.
Salesforce: Data 360 Architecture - Resolução de identidade, perfis unificados, integração e ativação.
Databricks: anúncio oficial do CustomerLake - Anúncio da solução em junho de 2026 e proposta de CDP agêntica.
Introducing CustomerLake: The Agentic CDP embedded in Databricks - Integração entre Customer 360, resolução de identidade, segmentação, ativação e agentes.
Databricks: página oficial do CustomerLake - Capacidades do produto, diagramas e exemplos visuais.
Databricks: arquiteturas de referência - Fundamentação da arquitetura de dados e IA.
ANPD: Perguntas frequentes sobre a LGPD
Lei nº 13.709/2018 (LGPD): texto oficial
Compartilhe