Databricks: o que é, como funciona e como pode transformar a estratégia de Dados e IA da sua empresa
A quantidade de dados produzidos pelas empresas cresceu, mas o desafio deixou de ser apenas armazená-los. Hoje, as organizações precisam integrar diferentes fontes, processar grandes volumes de informação, garantir qualidade e governança, disponibilizar dados para analytics e BI e, cada vez mais, utilizá-los como base para machine learning e inteligência artificial.
Quando essas necessidades crescem de forma isolada, a arquitetura de dados também tende a crescer de maneira fragmentada. Um ambiente pode ter um data lake para armazenamento, um data warehouse para analytics, ferramentas específicas para engenharia de dados, outras para machine learning e diferentes soluções para governança e segurança.
É nesse cenário que o Databricks ganhou espaço como uma plataforma para unificar dados, analytics e inteligência artificial.
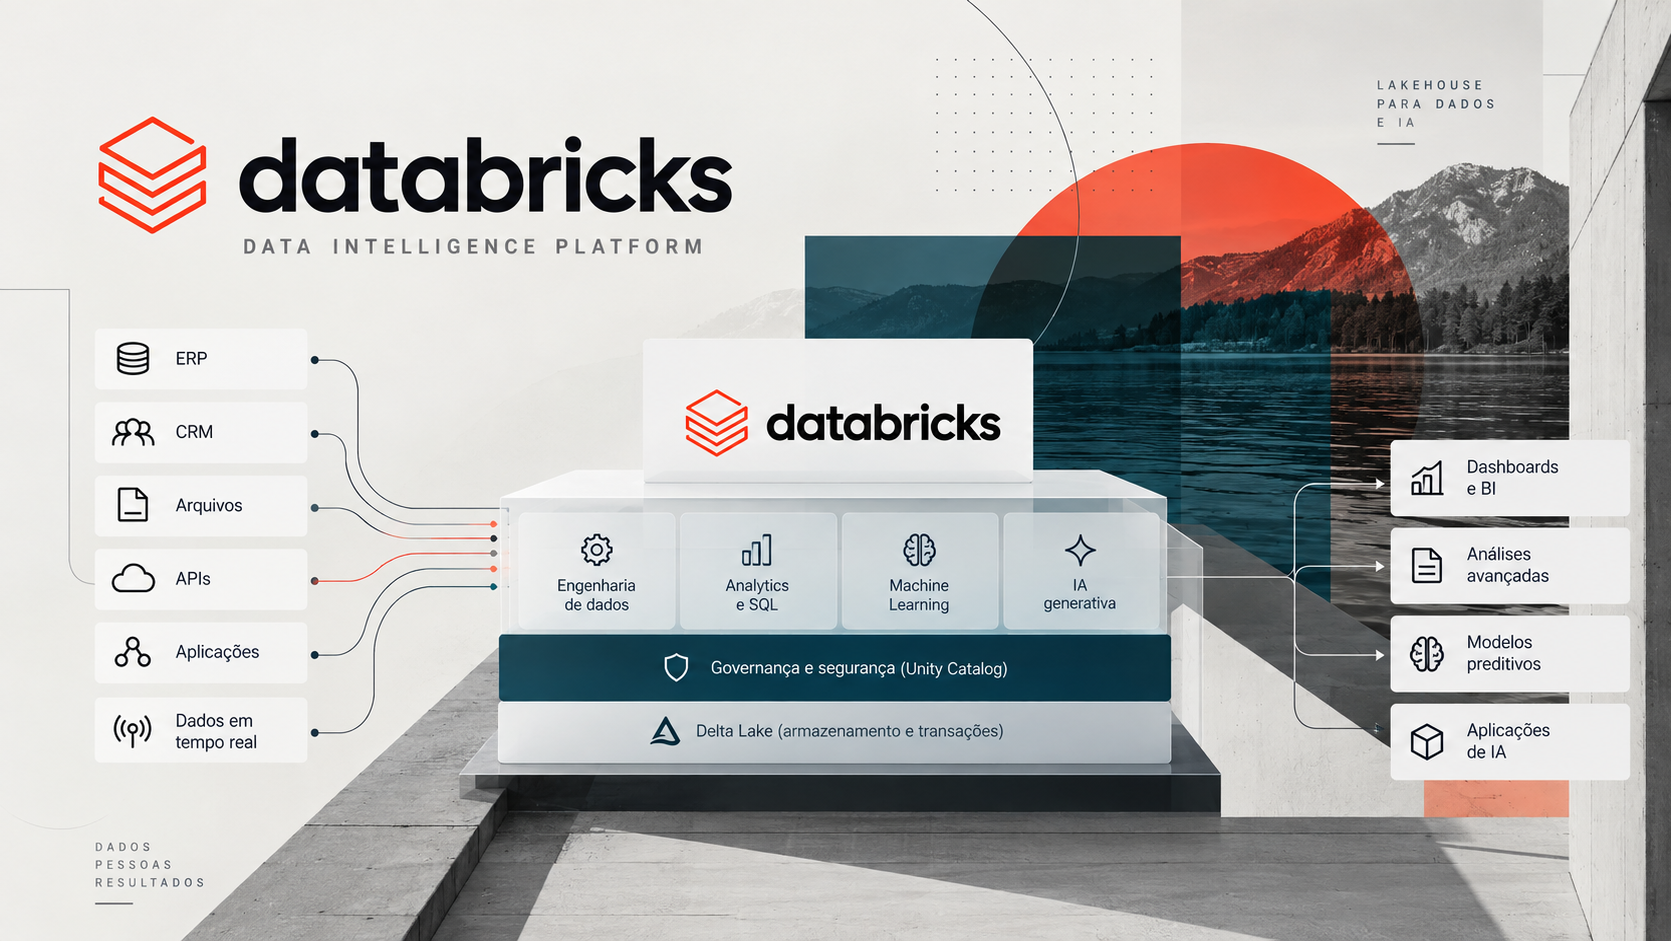
Construído sobre o conceito de Data Lakehouse, o Databricks reúne recursos para engenharia de dados, processamento em lote e streaming, SQL e BI, machine learning, inteligência artificial e governança em uma arquitetura integrada.
Para empresas que estão modernizando sua arquitetura de dados ou ampliando o uso de IA, essa integração pode reduzir a fragmentação tecnológica e criar uma base mais preparada para novos workloads.
Neste artigo, vamos explicar como o Databricks funciona, o que está por trás da arquitetura Lakehouse, quais são seus principais componentes e como a plataforma pode ser aplicada em diferentes cenários empresariais.
O que é Databricks?
O Databricks oferece serviços para ingestão e transformação de dados, processamento em lote e streaming, consultas SQL, visualização, experimentação e operação de modelos, além de recursos para aplicações de IA. Desse modo, o Databricks é uma plataforma unificada de dados e inteligência artificial que permite integrar, processar, analisar e governar informações em um mesmo ambiente. Construída sobre a arquitetura Data Lakehouse, a plataforma reúne recursos para engenharia de dados, Business Intelligence, machine learning e IA generativa, permitindo que diferentes equipes utilizem dados compartilhados e governados para suas atividades.
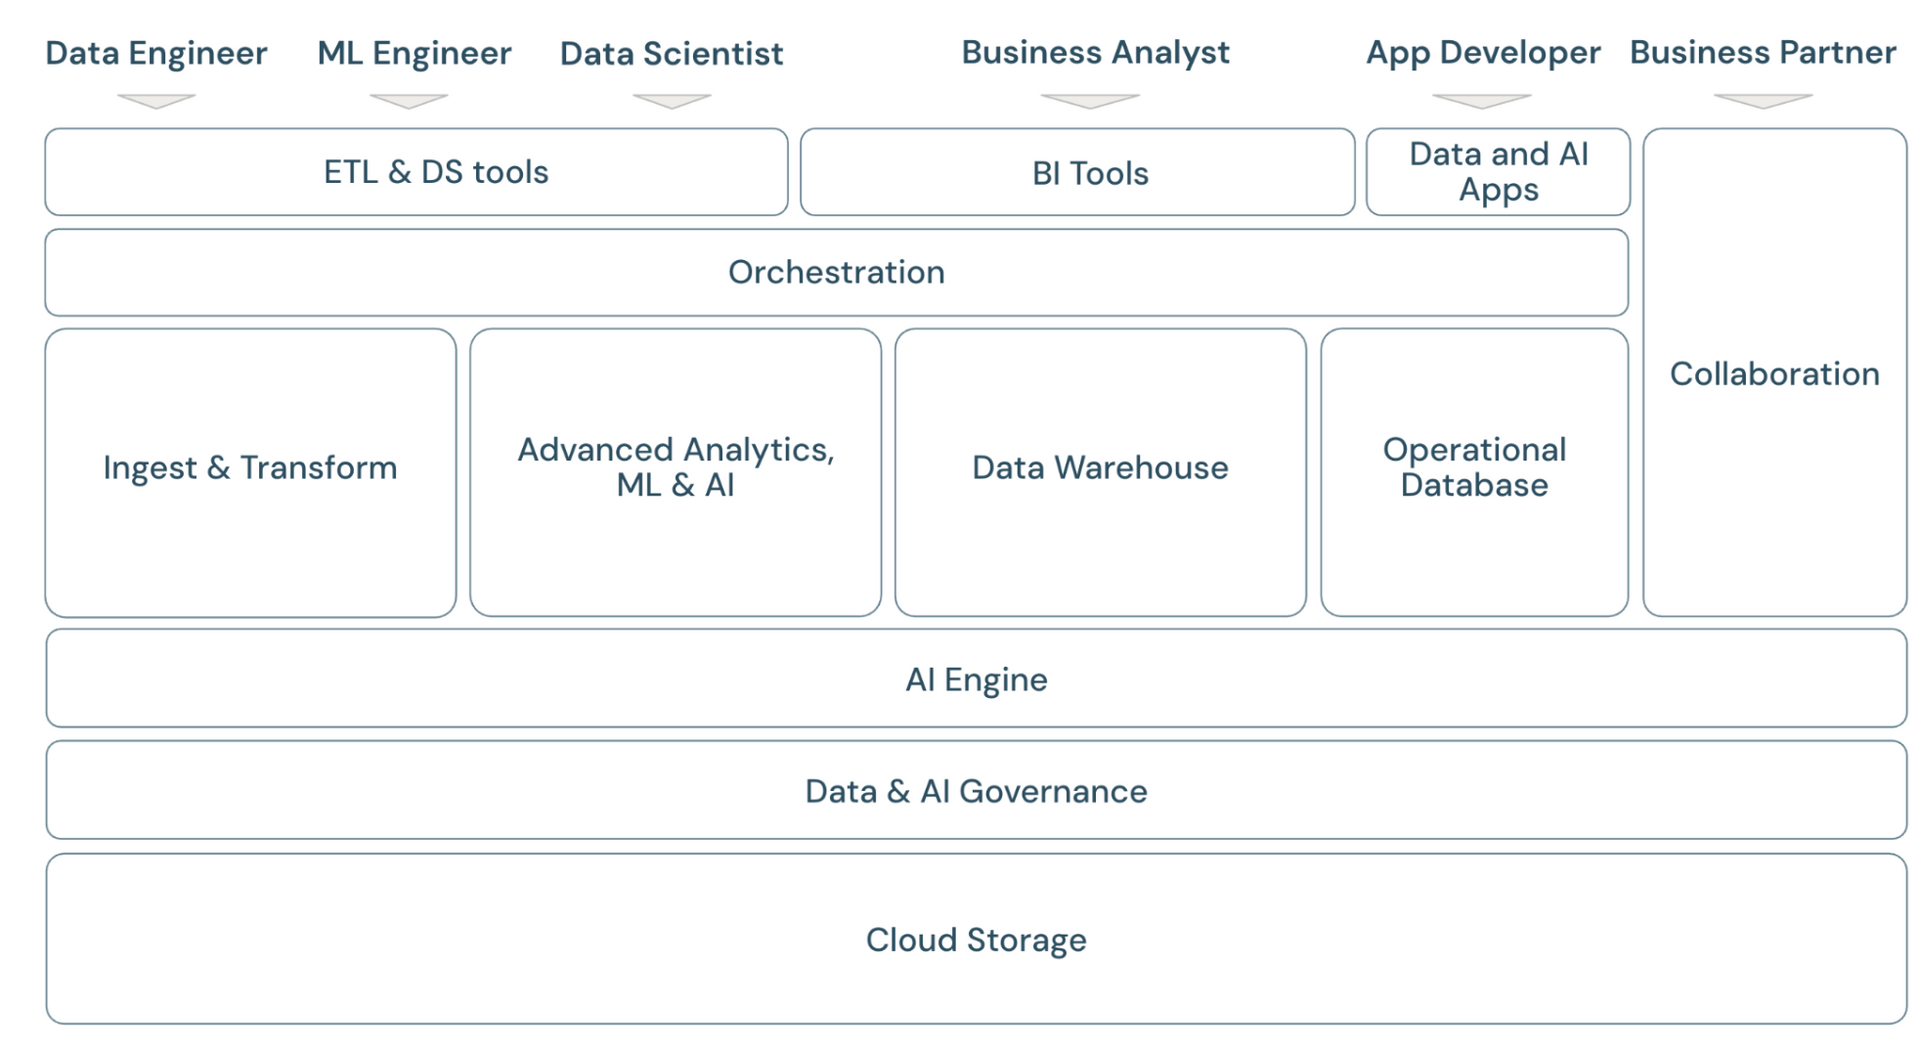
A plataforma reúne recursos que atendem a diferentes etapas do ciclo de vida dos dados:
- ingestão e engenharia de dados;
- processamento batch e streaming;
- armazenamento e gerenciamento de dados;
- analytics e SQL;
- Business Intelligence;
- machine learning;
- inteligência artificial generativa;
- governança e segurança;
- compartilhamento de dados.
Essa integração permite que diferentes equipes trabalhem sobre uma mesma base tecnológica.
Um engenheiro de dados pode construir pipelines de ingestão e transformação. Um analista pode consultar as tabelas utilizando SQL. Um cientista de dados pode utilizar esses mesmos dados para treinamento de modelos. Uma equipe de BI pode conectar ferramentas analíticas ao ambiente. E aplicações de IA podem utilizar dados corporativos governados para gerar respostas, previsões ou executar tarefas.
O ponto central está na possibilidade de trabalhar com esses diferentes workloads sobre uma arquitetura de dados comum.
Isso é especialmente relevante em ambientes corporativos porque os mesmos dados normalmente precisam atender diferentes necessidades.
Imagine, por exemplo, uma empresa que possui informações de vendas, estoque, produção, logística e relacionamento com clientes.
O time de operações pode precisar de dados atualizados continuamente para acompanhar a operação. A área financeira pode trabalhar com dados consolidados para análises de margem. O time de marketing pode cruzar comportamento dos clientes com histórico de compras. Já uma iniciativa de machine learning pode utilizar essas mesmas informações para construir modelos de previsão.
Em uma arquitetura fragmentada, cada necessidade pode acabar criando seu próprio fluxo de dados.
Em uma arquitetura Lakehouse bem estruturada, esses workloads podem compartilhar uma mesma base de dados, com processos de engenharia e governança centralizados.
Ao compartilhar uma arquitetura comum, as equipes podem reduzir integrações redundantes, estabelecer padrões de qualidade e acesso e simplificar a manutenção dos processos de dados. Na prática, isso pode facilitar a disponibilização de informações para diferentes áreas e criar condições para desenvolver novas aplicações analíticas e de IA sem precisar estruturar ambientes independentes para cada iniciativa.
O que é Data Lakehouse?
O conceito de Data Lakehouse está no centro da arquitetura do Databricks.
Para entender sua importância, vale observar como os ambientes tradicionais de dados evoluíram.
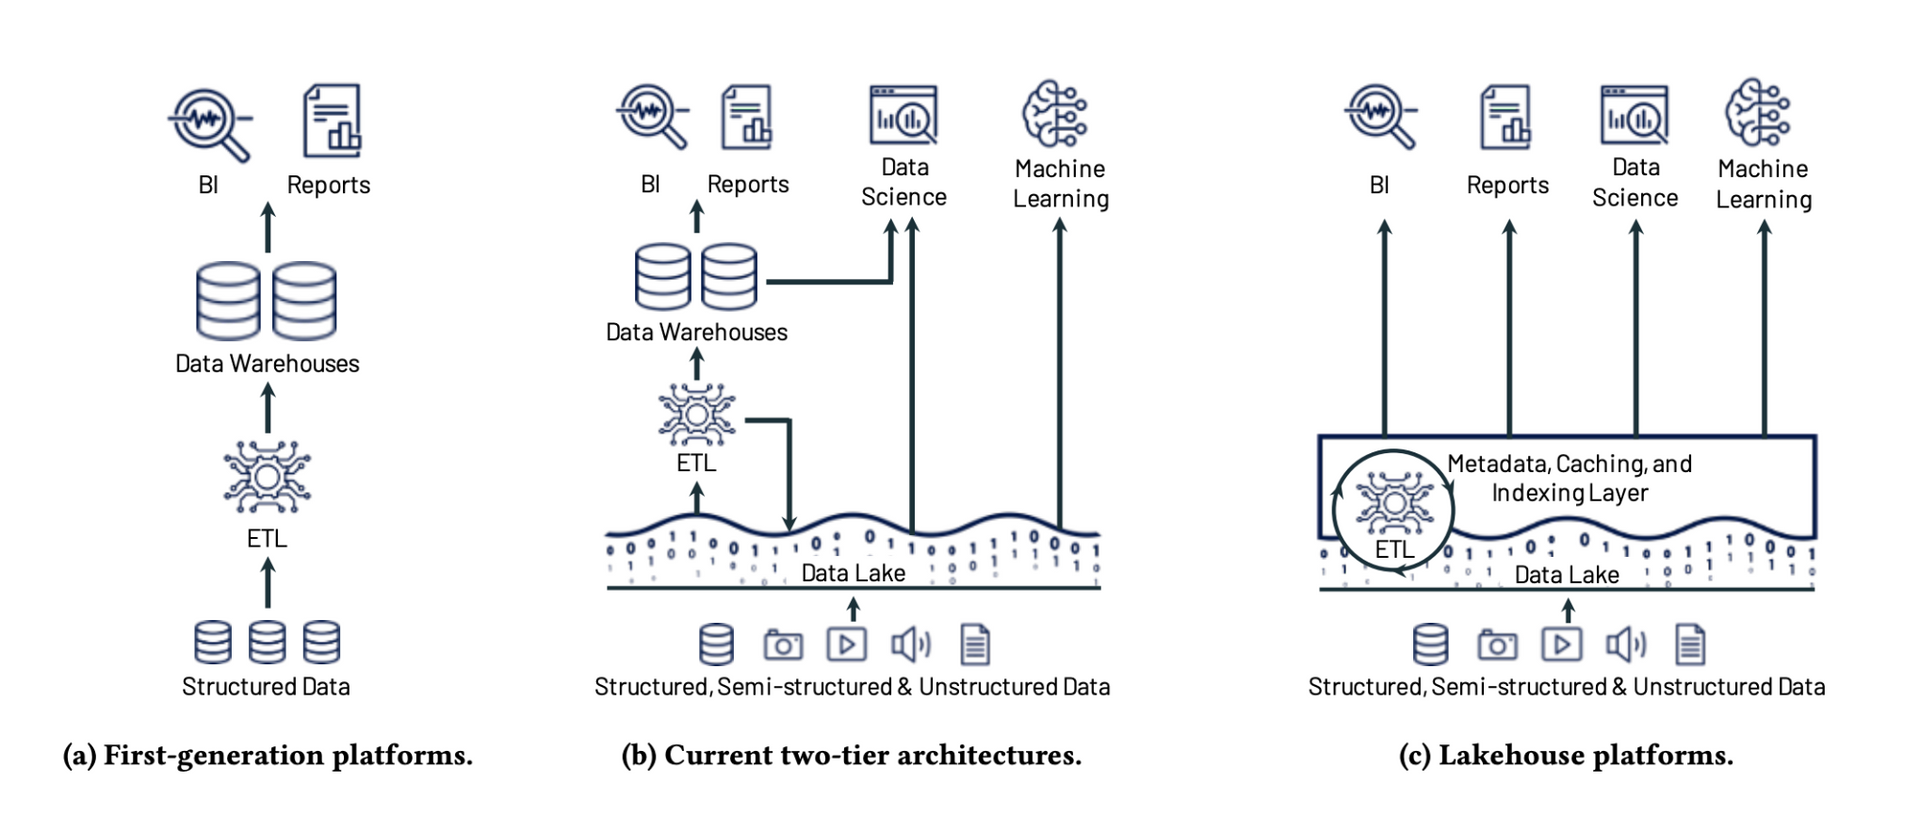
Imagem 02: Evolução das arquiteturas de plataformas de dados para o modelo de duas camadas atual (a-b) e para o novo modelo Lakehouse (c).
Fonte:
Databricks
O Data Lake surgiu como uma alternativa para armazenar grandes volumes de dados em diferentes formatos. Em vez de exigir que todas as informações fossem previamente estruturadas, o data lake permitia armazenar dados estruturados, semiestruturados e não estruturados em uma camada de armazenamento escalável.
Essa flexibilidade trouxe benefícios importantes, especialmente para empresas com grande volume e variedade de dados.
Ao mesmo tempo, os Data Warehouses continuaram sendo muito utilizados para analytics e Business Intelligence, oferecendo recursos voltados à consulta e análise de dados estruturados.
Na prática, muitas empresas passaram a operar com os dois modelos.
O problema é que manter os ambientes separados pode gerar movimentação constante de dados entre sistemas.
Um dado é armazenado no lake, depois transformado, copiado para o warehouse, novamente preparado para uma aplicação de machine learning e eventualmente replicado para outros ambientes.
Cada cópia adiciona processos, custos e pontos de controle.
O Data Lakehouse combina a flexibilidade de armazenamento dos Data Lakes com recursos de gerenciamento, confiabilidade e processamento analítico tradicionalmente associados aos Data Warehouses. Essa arquitetura utiliza uma base de dados compartilhada, geralmente apoiada em armazenamento de objetos na nuvem, e incorpora tecnologias que permitem controlar transações, organizar metadados, aplicar políticas de governança e disponibilizar informações para diferentes tipos de processamento.
Isso permite utilizar a mesma arquitetura para:
Armazenamento → Engenharia → Analytics → BI → Machine Learning → IA
com uma camada de governança integrada.
Isso não significa que todas as informações precisam permanecer em uma única tabela ou que a movimentação de dados entre sistemas deixa de existir.
Dependendo das necessidades da empresa, ainda podem ser necessárias camadas de transformação, estruturas derivadas e integrações com outras plataformas. A proposta do Lakehouse é organizar esses processos em uma arquitetura mais integrada, reduzindo duplicações desnecessárias e facilitando a governança dos dados.
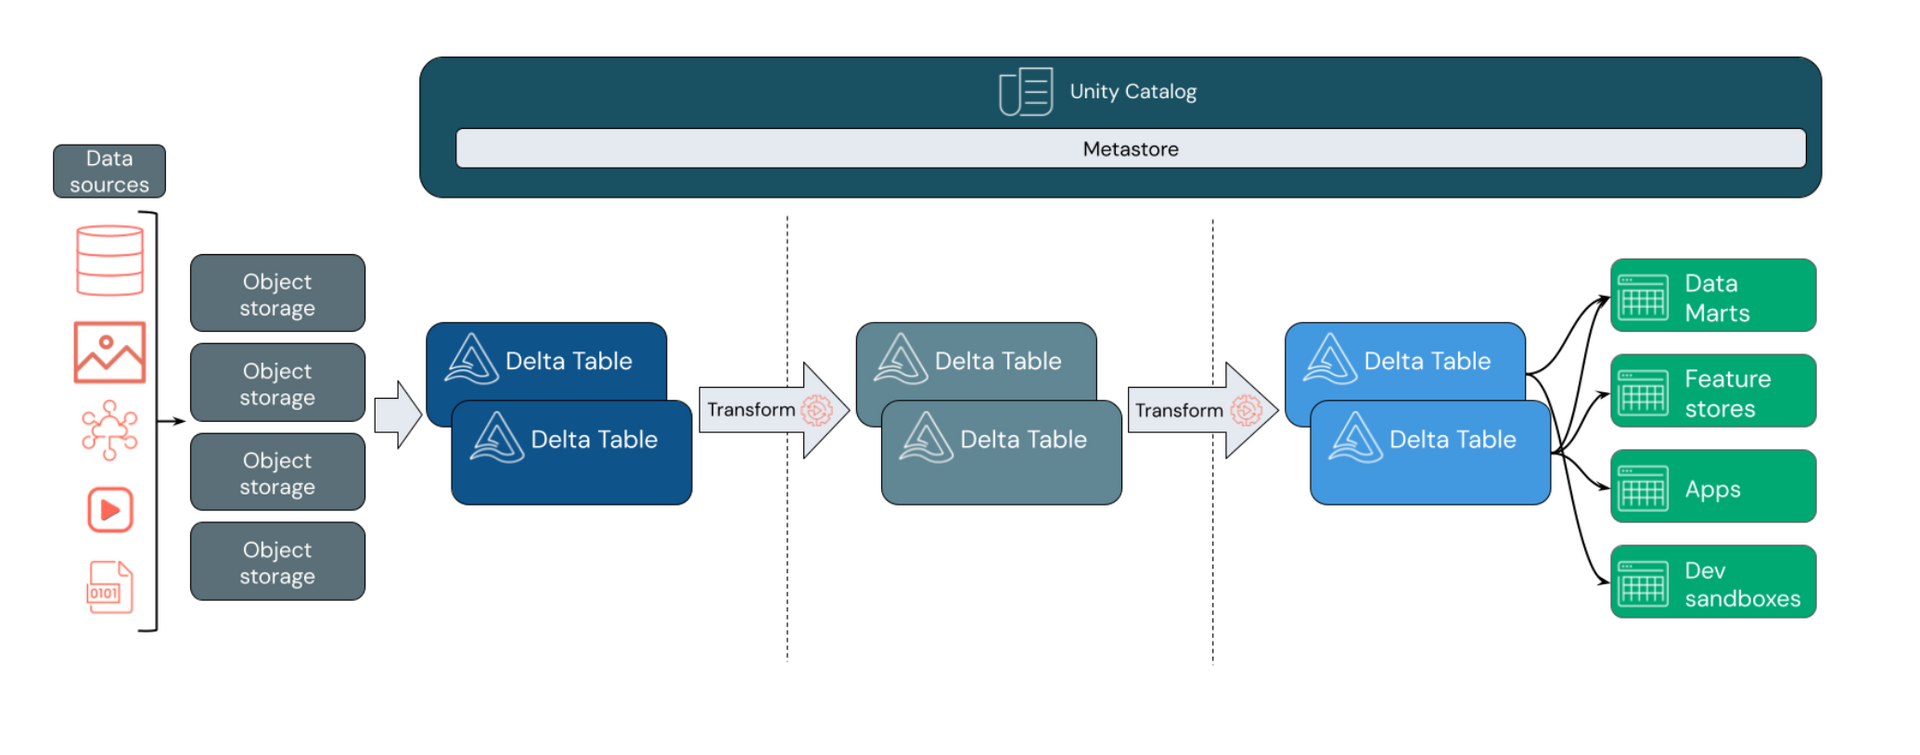
Imagem 03: Diagrama de arquitetura Lakehouse
Fonte:
Databricks
Essa arquitetura é particularmente interessante para empresas que precisam trabalhar simultaneamente com dados estruturados e não estruturados, grandes volumes de informação e diferentes tipos de processamento.
O Lakehouse do Databricks na prática
Uma arquitetura Lakehouse não é apenas um local para armazenar dados.
Ela precisa organizar como os dados chegam, onde são armazenados, como são transformados, quais regras de qualidade são aplicadas, quem pode acessá-los e como serão consumidos.
No Databricks, essa arquitetura é composta por diferentes tecnologias que trabalham em conjunto.
Entre elas estão:
- Delta Lake, para armazenamento confiável;
- Unity Catalog, para governança;
- Lakeflow, para ingestão e engenharia de dados;
- Databricks SQL, para analytics;
- recursos de Machine Learning;
- ferramentas e serviços para IA generativa e agentes.
Cada componente possui uma função específica, mas o ganho está justamente na integração entre eles.
Imagine uma empresa que precisa integrar informações de vendas, estoque e relacionamento com clientes para acompanhar seus indicadores comerciais.
Os dados podem ser recebidos de diferentes sistemas por meio de pipelines de ingestão, organizados e transformados em tabelas Delta e disponibilizados para análises. Durante esse processo, o Unity Catalog ajuda a controlar permissões, organizar os ativos e acompanhar a linhagem das informações.
Com os dados preparados, as equipes podem utilizar o Databricks SQL para realizar consultas, alimentar dashboards e desenvolver análises. Essas mesmas informações também podem servir de base para modelos preditivos ou aplicações de inteligência artificial.
Esse exemplo mostra como engenharia de dados, armazenamento, governança e analytics podem funcionar de maneira integrada dentro da arquitetura Lakehouse.
Delta Lake: confiabilidade para o Data Lake
Um dos fundamentos do Lakehouse é o Delta Lake, uma camada de armazenamento open source que adiciona recursos de confiabilidade e gerenciamento de dados sobre data lakes.
Em um ambiente corporativo, armazenar arquivos em um object storage não é suficiente.
Imagine uma tabela que recebe milhões de registros diariamente enquanto diferentes usuários e processos fazem consultas sobre esses dados.
É necessário garantir que as operações sejam consistentes e que alterações possam ser controladas.
O Delta Lake utiliza um transaction log para registrar alterações e oferece recursos como transações ACID, schema enforcement, schema evolution e time travel.
Transações ACID
As transações ACID ajudam a garantir consistência nas operações de dados. Isso é especialmente importante quando diferentes processos estão lendo e escrevendo dados simultaneamente.
Schema enforcement
O schema enforcement ajuda a evitar que dados incompatíveis sejam inseridos em uma tabela sem controle. Imagine um pipeline que espera receber uma coluna customer_id como número, mas uma nova versão da fonte passa a enviá-la como texto. Sem mecanismos de validação, alterações desse tipo podem provocar problemas downstream.
Schema evolution
Em determinados cenários, o schema dos dados precisa evoluir. Novas colunas podem ser adicionadas às fontes, por exemplo. O Delta Lake oferece mecanismos para lidar com essas mudanças de maneira controlada, evitando que a evolução natural dos sistemas de origem se transforme em um problema para os pipelines.
Time Travel
Outro recurso importante é o Time Travel, que permite acessar versões anteriores de uma tabela. Isso pode ser útil para auditoria, investigação de alterações, recuperação de dados e validação de processos. É importante considerar que o Time Travel depende das políticas de retenção e da disponibilidade dos arquivos necessários para reconstruir versões anteriores da tabela. Operações de manutenção, como o VACUUM, podem remover arquivos antigos e limitar esse histórico. Por isso, o recurso não substitui uma estratégia de backup ou arquivamento de longo prazo.
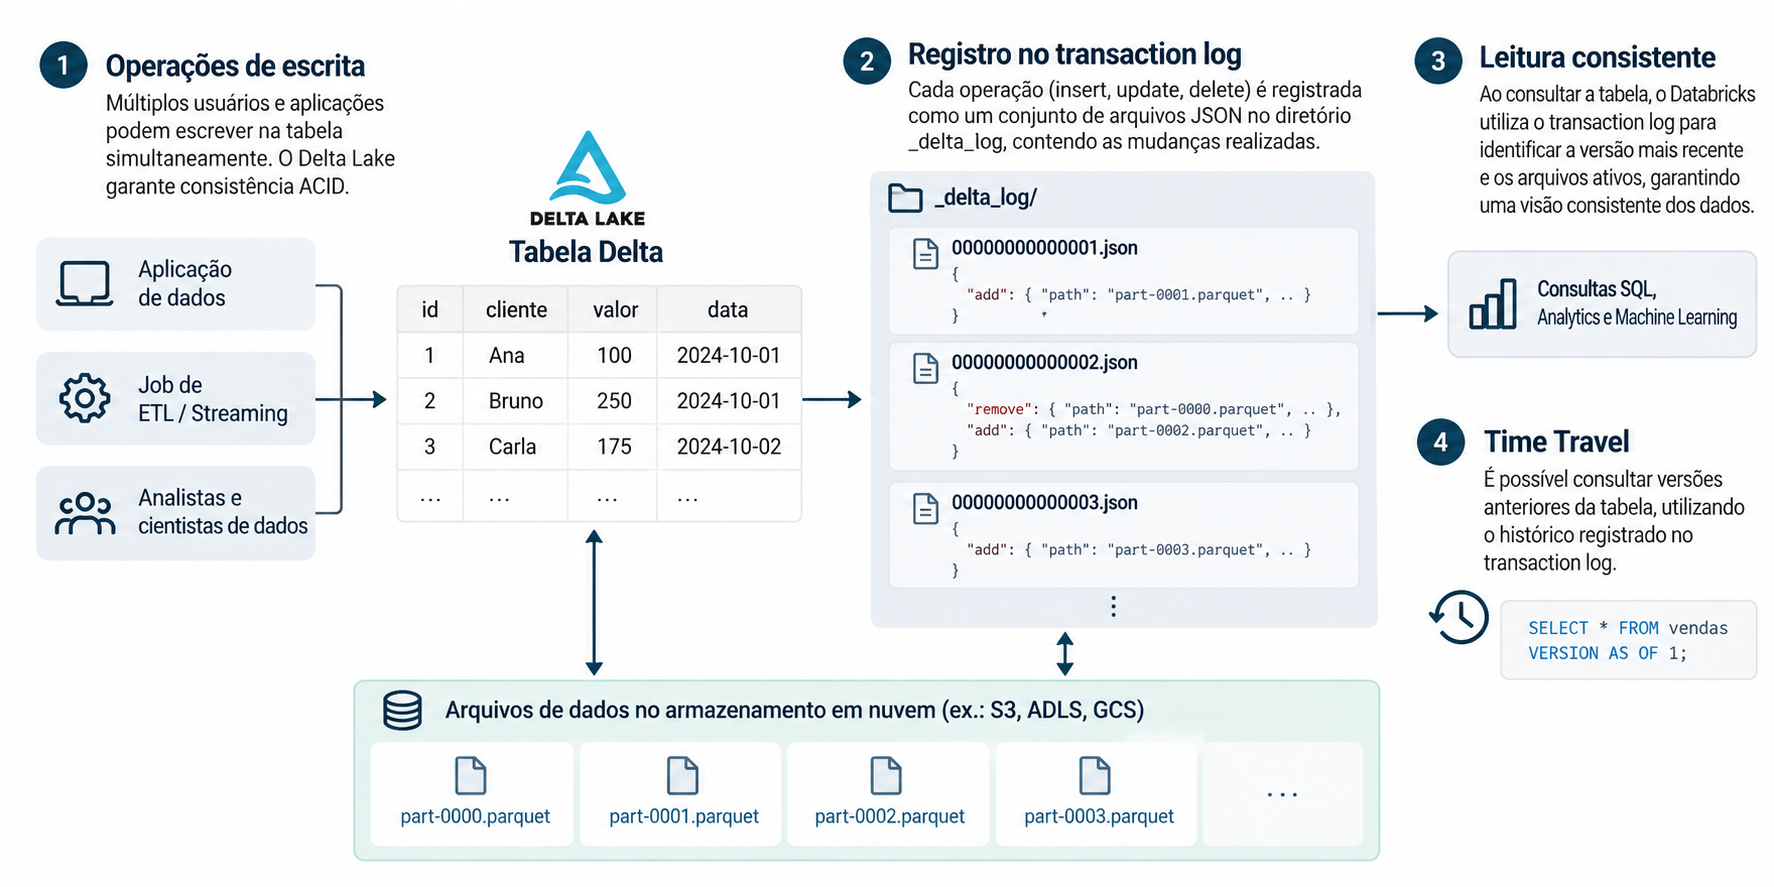
Imagem 04: Funcionamento do Transaction Log do Delta Lake, responsável por registrar alterações nas tabelas, garantir a consistência das operações e permitir consultas a versões anteriores dos dados (Time Travel).
Fonte: Elaboração Five Acts, com base na arquitetura do Delta Lake.
Esses recursos fazem diferença principalmente em ambientes nos quais dados são utilizados para decisões críticas, análises financeiras, modelos de machine learning ou processos operacionais.
Medallion Architecture: organizando o ciclo de transformação dos dados
Outro conceito bastante utilizado em arquiteturas Lakehouse é a Medallion Architecture.
Ela organiza os dados de acordo com seu nível de transformação.
A arquitetura Medallion é um padrão de organização amplamente utilizado no Databricks, mas não é uma estrutura obrigatória para todos os projetos. Sua adoção depende das características dos dados, das necessidades de processamento e dos objetivos de cada ambiente.
A estrutura tradicional utiliza três camadas, como mostra a imagem a seguir:
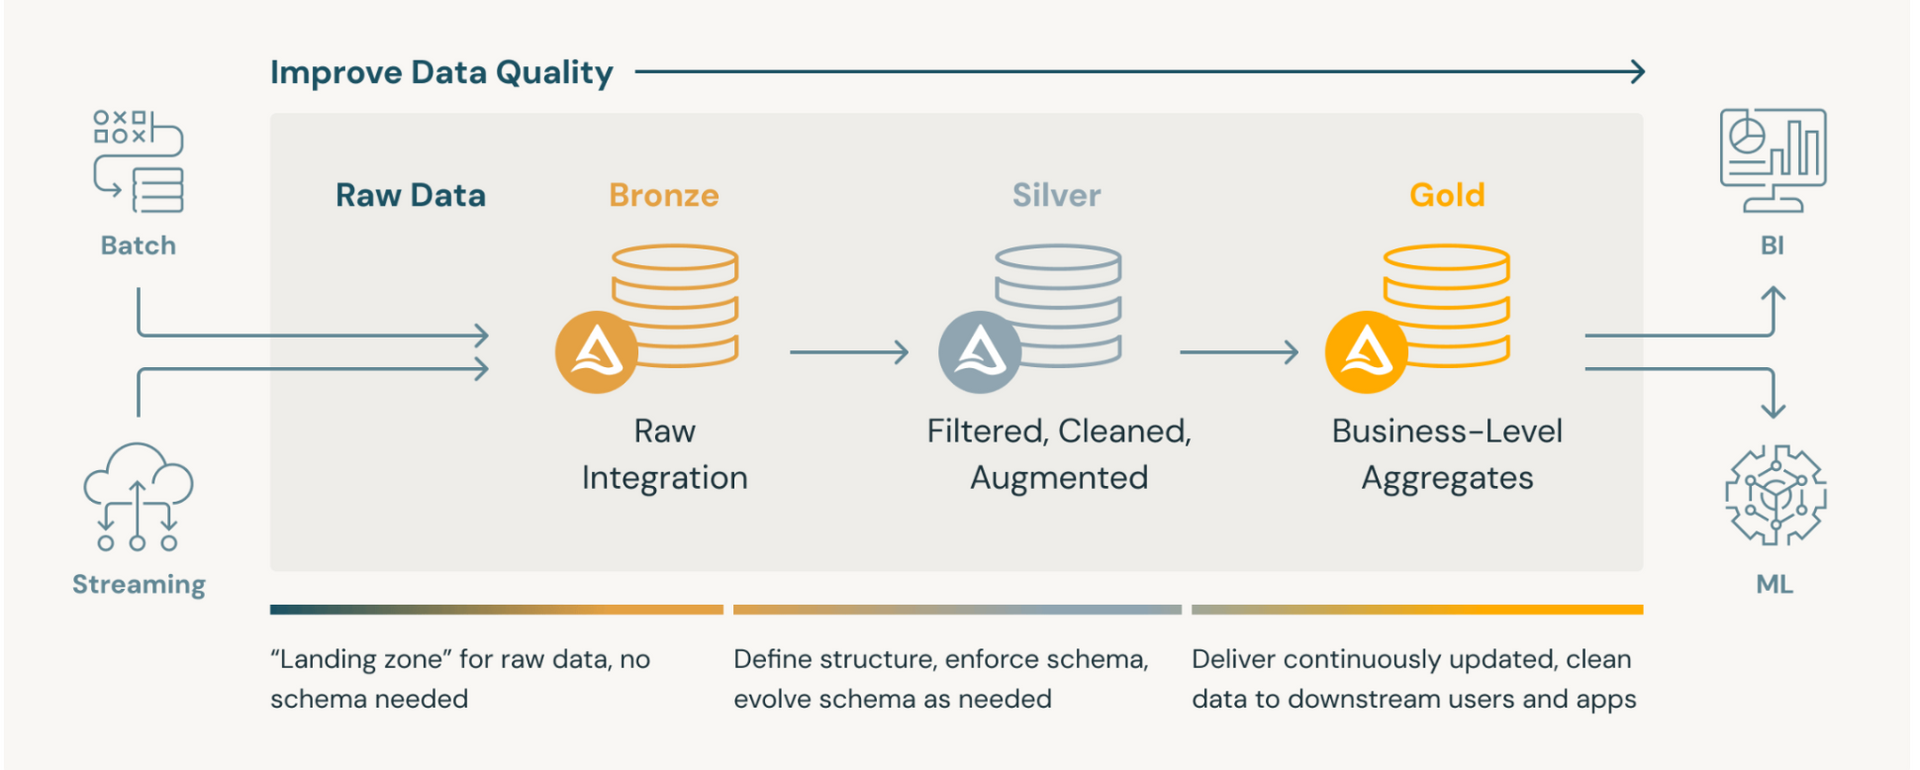
Imagem 05: Medallion Architecture
Fonte:
Databricks
Bronze: dados próximos da origem
A camada Bronze recebe os dados provenientes das fontes.
Pode conter informações vindas de:
- ERP;
- CRM;
- APIs;
- bancos relacionais;
- arquivos;
- aplicações;
- sensores;
- eventos de sistemas.
A ideia é preservar os dados de origem com o mínimo de transformação necessário para a ingestão.
Isso cria uma camada de referência que pode ser utilizada para reprocessamento caso uma regra de transformação seja alterada posteriormente.
Silver: dados tratados e integrados
Na camada Silver, os dados passam por processos mais estruturados.
Aqui podem acontecer:
- limpeza;
- deduplicação;
- padronização;
- validação;
- enriquecimento;
- integração entre fontes;
- aplicação de regras de negócio.
Imagine que uma empresa receba informações de clientes de três sistemas diferentes.
Na Silver, esses dados podem ser padronizados e integrados para criar uma visão consistente do cliente.
Gold: dados preparados para consumo
A camada Gold representa os dados preparados para necessidades específicas de negócio.
É onde podem existir modelos analíticos, tabelas agregadas e estruturas destinadas a determinados domínios ou áreas.
Por exemplo:
- vendas por região;
- margem por produto;
- indicadores financeiros;
- estoque;
- desempenho logístico;
- comportamento de clientes.
Esses dados podem alimentar dashboards, relatórios, modelos analíticos e aplicações.
A vantagem dessa organização é separar claramente o dado de origem do dado tratado e do dado preparado para consumo.
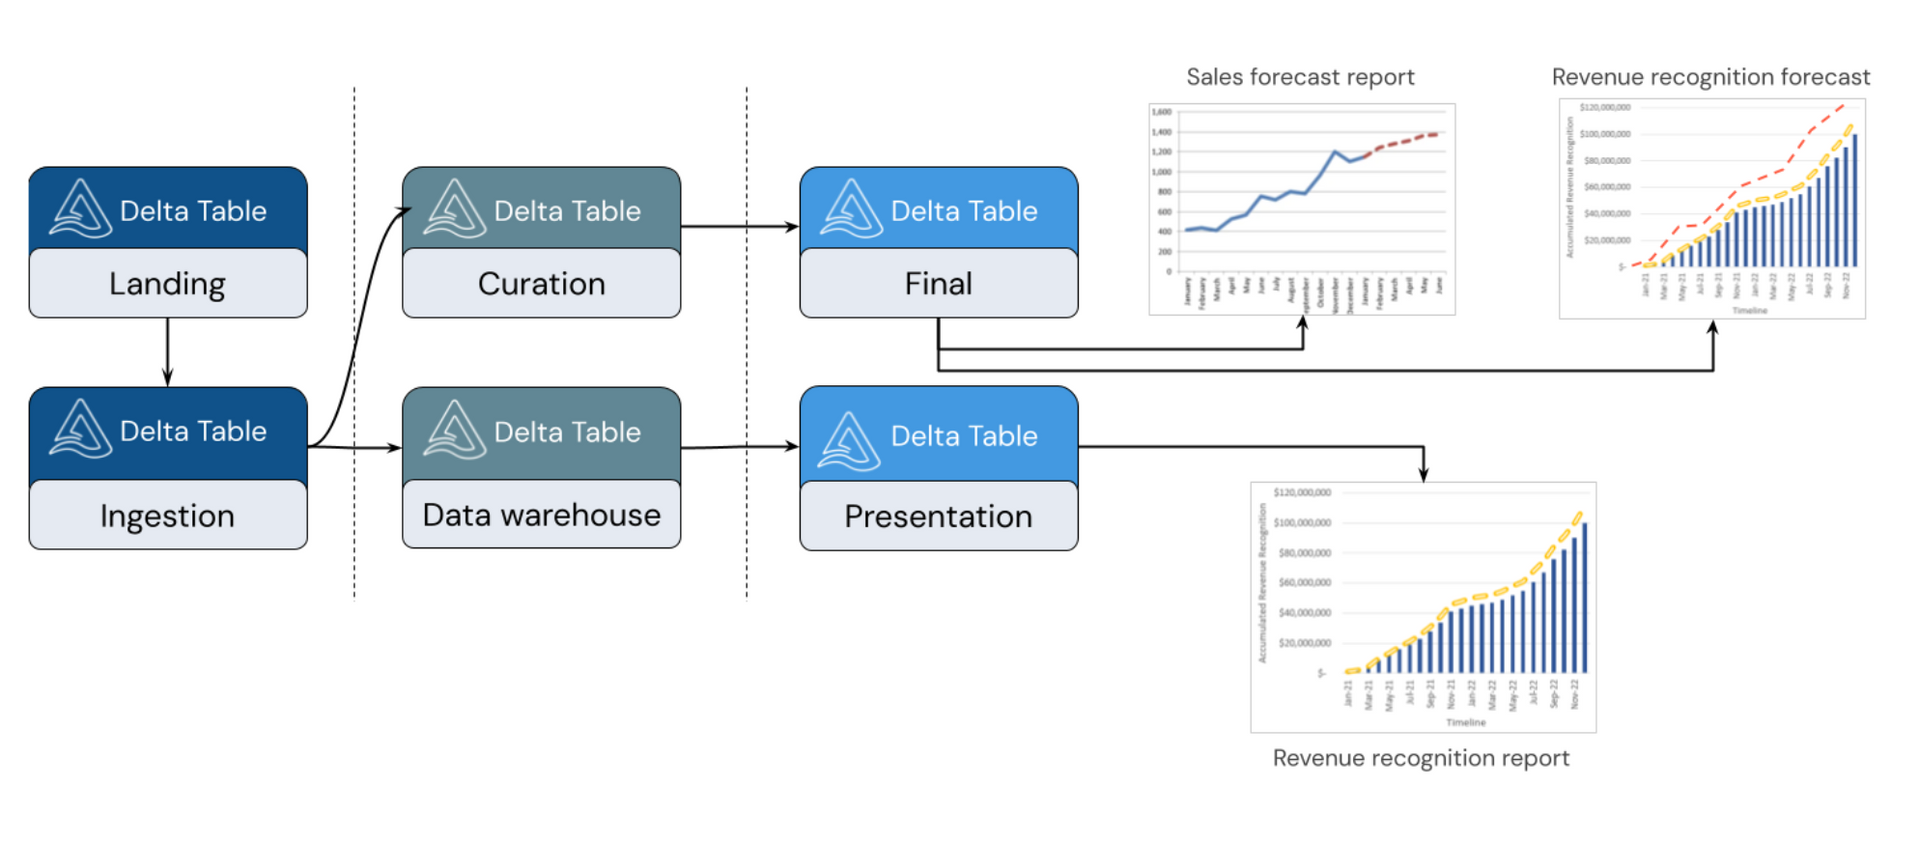
Imagem 06: Fluxo de organização e modelagem de dados à medida que passam por diferentes camadas de uma lakehouse.
Fonte:
Databricks
Unity Catalog: governança centralizada dos dados
Conforme a arquitetura cresce, surge outro desafio: saber exatamente quais dados existem, quem pode acessá-los e como estão sendo utilizados.
É nesse ponto que entra o Unity Catalog.
O Unity Catalog é a camada de governança do Databricks para dados e ativos de IA.
Ele permite centralizar diferentes mecanismos de controle e visibilidade sobre o ambiente, incluindo:
- controle de acesso;
- descoberta de dados;
- linhagem;
- auditoria;
- classificação;
- monitoramento;
- gerenciamento de ativos de dados e IA.
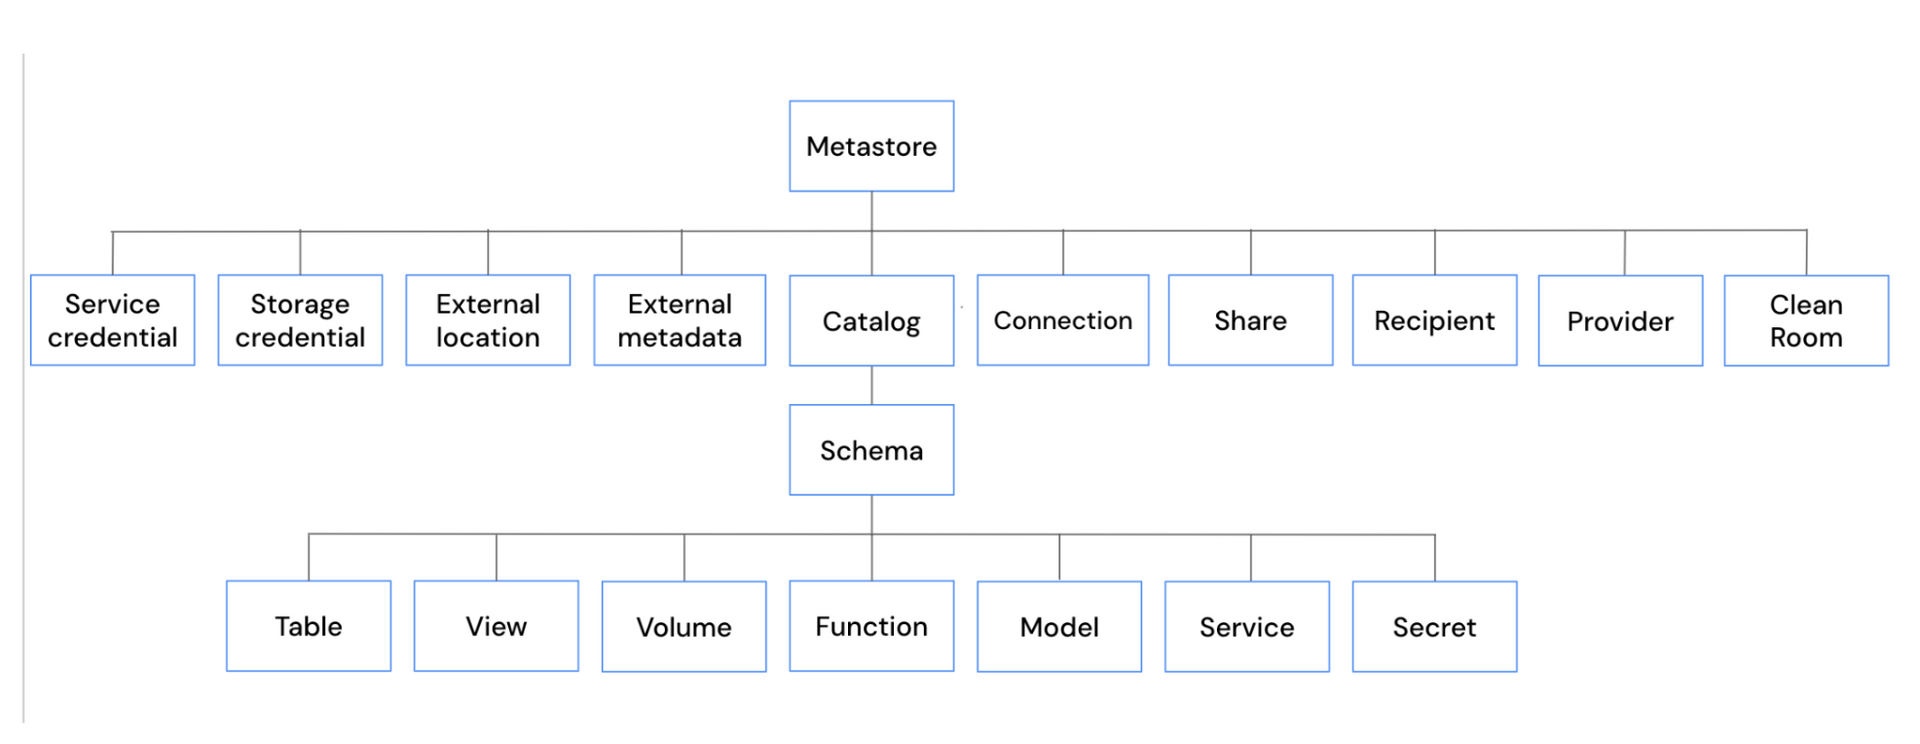
A estrutura de organização utiliza conceitos como catalog, schema e tables, criando uma hierarquia para os objetos governados.
Por exemplo:
Catalog → Schema → Table
Essa organização ajuda a estruturar os dados de acordo com domínios, ambientes ou necessidades organizacionais.
Mas governança não significa apenas saber onde uma tabela está.
Em um ambiente corporativo, também é importante entender de onde o dado veio e para onde ele foi.
A linhagem de dados permite visualizar relações entre ativos e compreender como determinadas tabelas, views ou outros objetos foram utilizados na construção de um resultado.
Isso pode ser particularmente importante quando uma empresa precisa investigar uma informação apresentada em um relatório ou identificar o impacto de uma alteração em determinado conjunto de dados.
Controle de acesso
O Unity Catalog também permite estabelecer políticas de acesso.
Isso possibilita definir quais usuários, grupos ou serviços podem consultar ou modificar determinados ativos.
Em ambientes com dados sensíveis, podem ser utilizados mecanismos como filtros de linhas e máscaras de colunas para limitar a exposição de determinadas informações.
Por exemplo, uma mesma tabela pode conter dados de clientes utilizados por diferentes áreas, mas determinadas informações pessoais podem precisar ser protegidas de acordo com o perfil do usuário.
A governança permite estruturar esse acesso de forma centralizada.
Embora o Unity Catalog ofereça recursos importantes para governança e segurança, sua implementação não garante, por si só, conformidade com regulamentações como a Lei Geral de Proteção de Dados (LGPD). A proteção das informações também depende de políticas internas, definição de responsabilidades, gestão de identidades, regras de retenção e configuração adequada dos controles de acesso.
Engenharia de dados: levando informação das fontes até o negócio
Uma arquitetura Lakehouse precisa de uma engenharia de dados capaz de alimentar o ambiente continuamente.
O Databricks oferece recursos para diferentes padrões de ingestão e processamento, incluindo workloads batch e streaming.
O Lakeflow reúne diferentes recursos para ingestão, transformação e orquestração de dados. O Lakeflow Connect permite conectar fontes suportadas e realizar a ingestão de informações; o Lakeflow Spark Declarative Pipelines apoia o desenvolvimento e a execução de pipelines declarativos; e o Lakeflow Jobs permite orquestrar, agendar e monitorar a execução de tarefas.
Esses componentes podem trabalhar de forma integrada, ajudando as equipes de engenharia a organizar processos de dados com maior padronização e visibilidade operacional. A disponibilidade dos conectores e recursos deve ser avaliada de acordo com o ambiente utilizado.
Um pipeline pode começar com a ingestão de dados de uma fonte, aplicar transformações e regras de qualidade e disponibilizar os dados em tabelas que serão consumidas por outras equipes.
O processo pode ser automatizado e monitorado, reduzindo a necessidade de intervenções manuais.
Um exemplo simples seria uma empresa que recebe diariamente dados de vendas.
O pipeline poderia:
- receber os arquivos ou eventos da fonte;
- registrar os dados na camada Bronze;
- validar schema e qualidade;
- eliminar registros duplicados;
- padronizar campos;
- integrar informações de outras fontes;
- disponibilizar os dados na Silver;
- gerar tabelas agregadas para consumo analítico na Gold.
Esse mesmo fluxo pode ser adaptado para dados em tempo real quando a operação exige processamento contínuo.
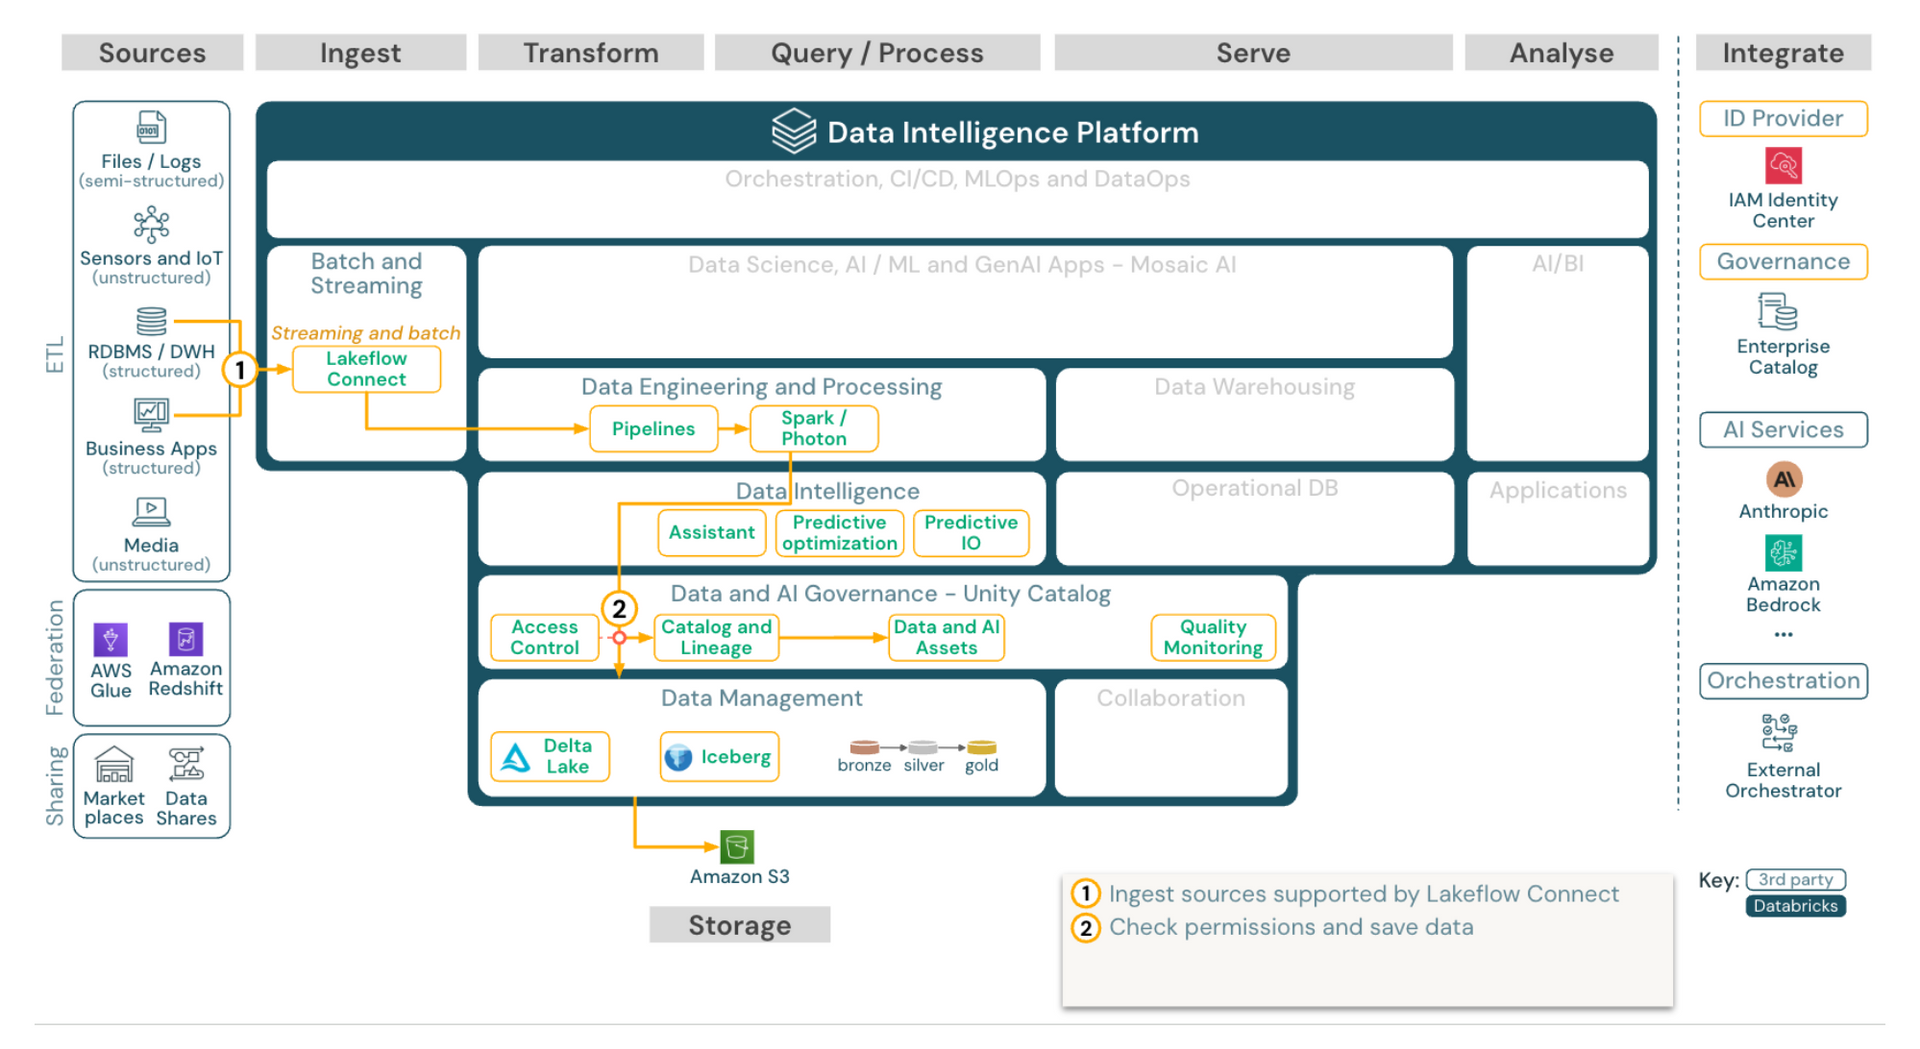
Imagem 08: Ingestão integrada de aplicativos e bancos de dados do site SaaS com LakeFlow Connect
Fonte:
Databricks
A engenharia de dados é uma das áreas em que a arquitetura faz diferença.
Quanto mais fontes e consumidores existem, maior é a necessidade de padronizar pipelines, controlar dependências, monitorar falhas e garantir que os dados estejam disponíveis dentro dos níveis de serviço esperados.
Analytics e Databricks SQL
Depois que os dados estão disponíveis e governados, eles precisam ser utilizados.
O Databricks SQL oferece um ambiente para executar consultas analíticas e trabalhar com workloads de SQL sobre os dados do Lakehouse.
Isso permite que profissionais que já utilizam SQL participem do ecossistema sem precisar trabalhar diretamente com todas as camadas de engenharia.
Um analista financeiro, por exemplo, pode consultar dados preparados no Lakehouse para analisar receita, margem ou custos.
Um time comercial pode trabalhar com indicadores de vendas.
Uma área de operações pode acompanhar produtividade ou desempenho logístico.
E uma equipe de BI pode utilizar os dados para construir dashboards em ferramentas de visualização conectadas ao ambiente.
Esse modelo também ajuda a reduzir uma situação comum em ambientes corporativos: cada área construir sua própria versão de uma métrica.
Quando os indicadores são baseados em dados governados e modelos bem definidos, fica mais fácil estabelecer uma referência comum para a organização.
Machine Learning: aproximando dados e modelos
Machine learning depende de dados confiáveis.
Antes de treinar um modelo, é necessário coletar dados, limpar informações, construir features, realizar transformações, testar hipóteses e avaliar resultados.
Depois do treinamento, ainda existem etapas de registro, implantação, monitoramento e atualização.
Quando os dados utilizados para treinamento estão em um ambiente diferente daquele onde os pipelines são executados, o processo pode exigir várias integrações.
O Databricks permite aproximar essas etapas dentro da mesma arquitetura.
O ecossistema de Machine Learning do Databricks inclui recursos para experimentação, treinamento, avaliação, implantação e monitoramento de modelos. O MLflow desempenha um papel importante nesse processo, permitindo registrar experimentos, acompanhar métricas, comparar resultados e gerenciar modelos ao longo de seu ciclo de vida.
Isso cria uma conexão importante:
Dados → Features → Treinamento → Avaliação → Modelo → Produção → Monitoramento
A proximidade entre engenharia de dados e machine learning pode reduzir o esforço necessário para transformar um modelo experimental em um componente operacional.
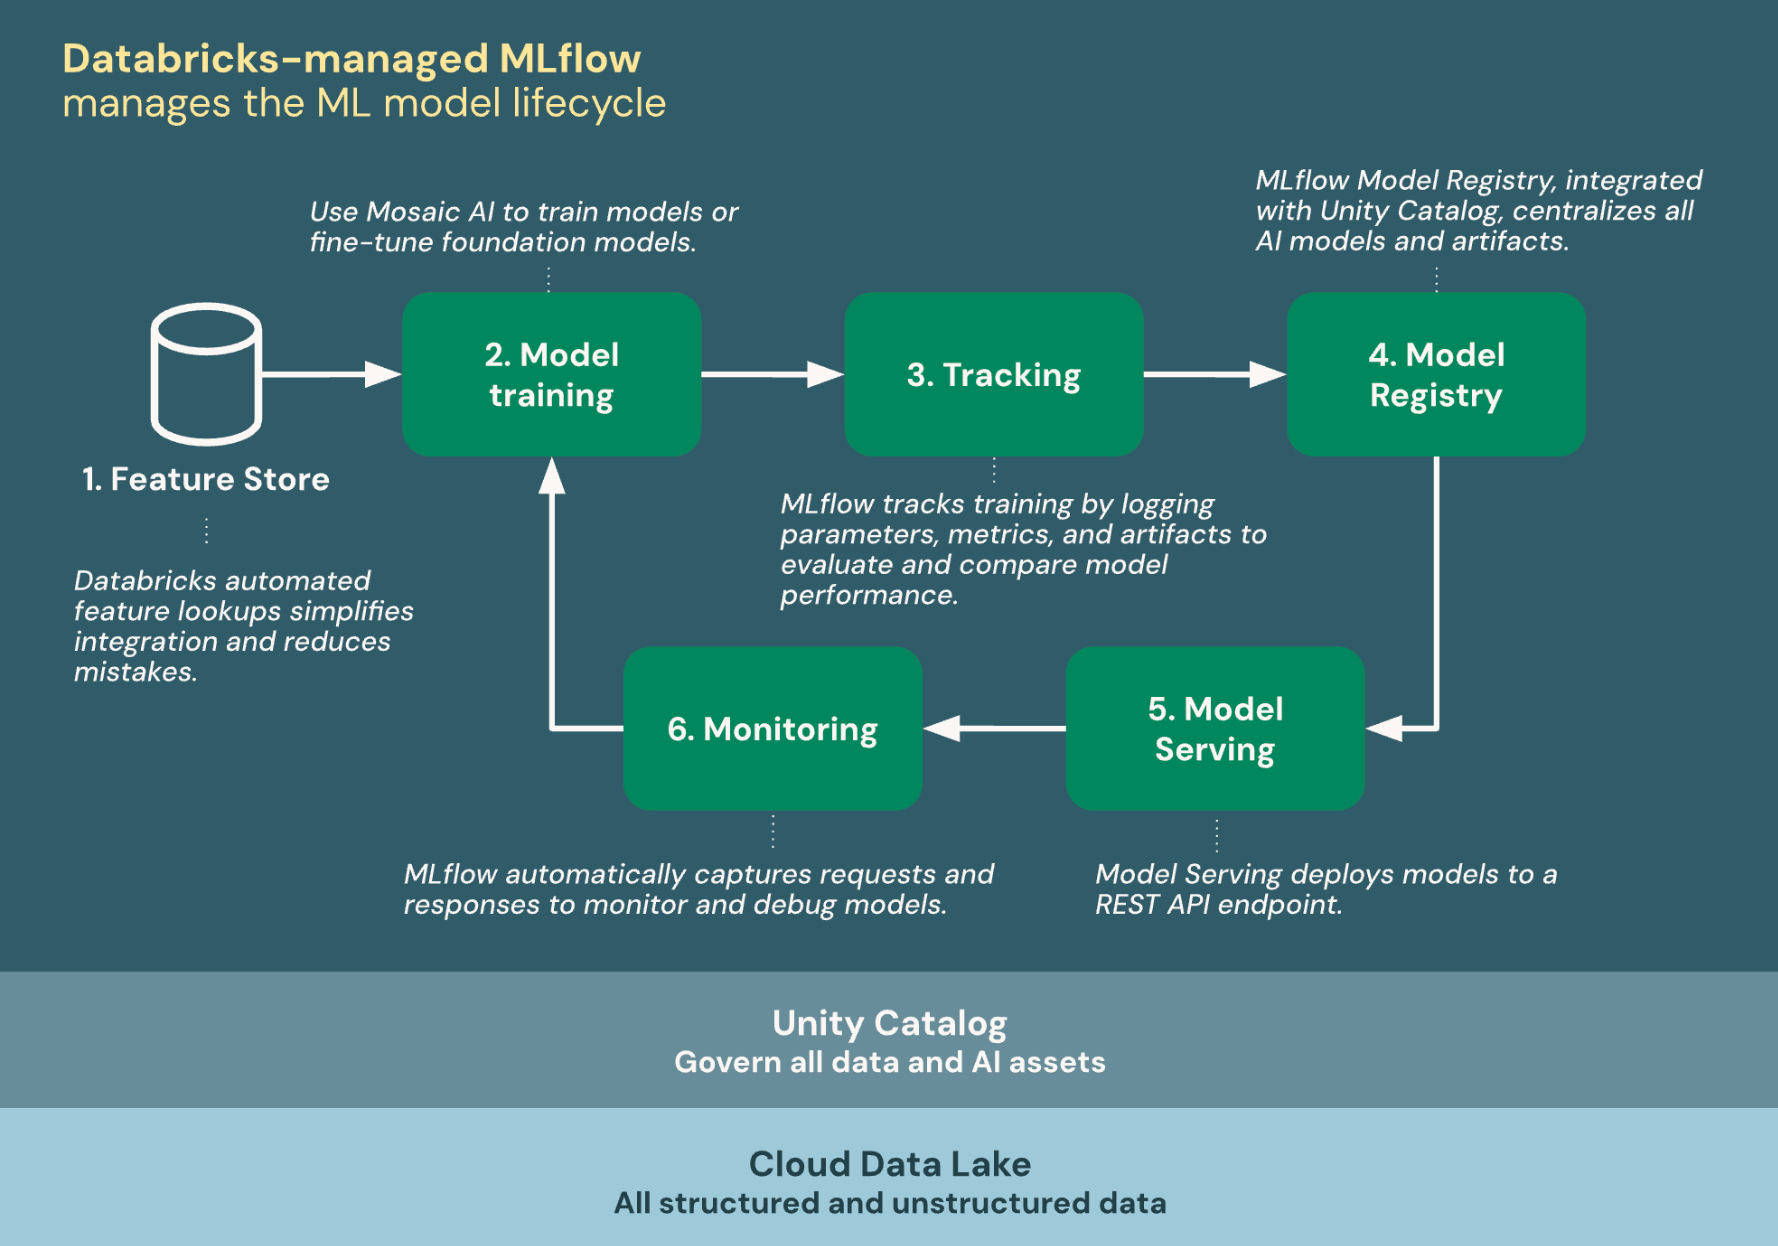
Imagem 09: Como o Databricks se integra ao MLflow para treinar e implantar o modelo de aprendizado de máquina.
Fonte:
Databricks
Databricks e inteligência artificial generativa
A evolução da plataforma também acompanha uma mudança importante no mercado: os dados corporativos passaram a ser um dos principais ativos para aplicações de IA generativa.
Uma empresa pode utilizar um modelo de linguagem disponível no mercado, mas o valor de uma aplicação corporativa normalmente depende do contexto fornecido a esse modelo.
Esse contexto pode estar em:
- tabelas;
- documentos;
- históricos;
- métricas;
- sistemas internos;
- bases de conhecimento;
- aplicações corporativas.
Por isso, projetos de IA empresarial precisam conectar modelos aos dados e às regras da organização.
O Databricks trabalha essa integração dentro do conceito de Data + AI.
A plataforma possui recursos para desenvolvimento de aplicações de IA, modelos, agentes, ferramentas e governança desses ativos.
Para aplicações de inteligência artificial generativa, o Databricks oferece recursos do ecossistema Mosaic AI, voltados ao desenvolvimento, à avaliação e à operação de aplicações e agentes de IA. Essas capacidades aproximam a engenharia de dados das etapas necessárias para levar modelos e aplicações inteligentes ao ambiente corporativo.
O Unity Catalog também assume um papel importante nesse cenário, porque os mesmos princípios de governança aplicados aos dados precisam ser considerados quando esses dados passam a alimentar aplicações e agentes de IA.
Isso inclui perguntas como:
- Quais dados podem ser acessados?
- Quem pode utilizar determinado modelo?
- Quais ferramentas um agente pode executar?
- Como monitorar o uso?
- Como controlar custos?
- Como avaliar a qualidade das respostas?
- Como rastrear as interações?
A adoção de IA em escala empresarial exige que essas questões façam parte da arquitetura desde o início.
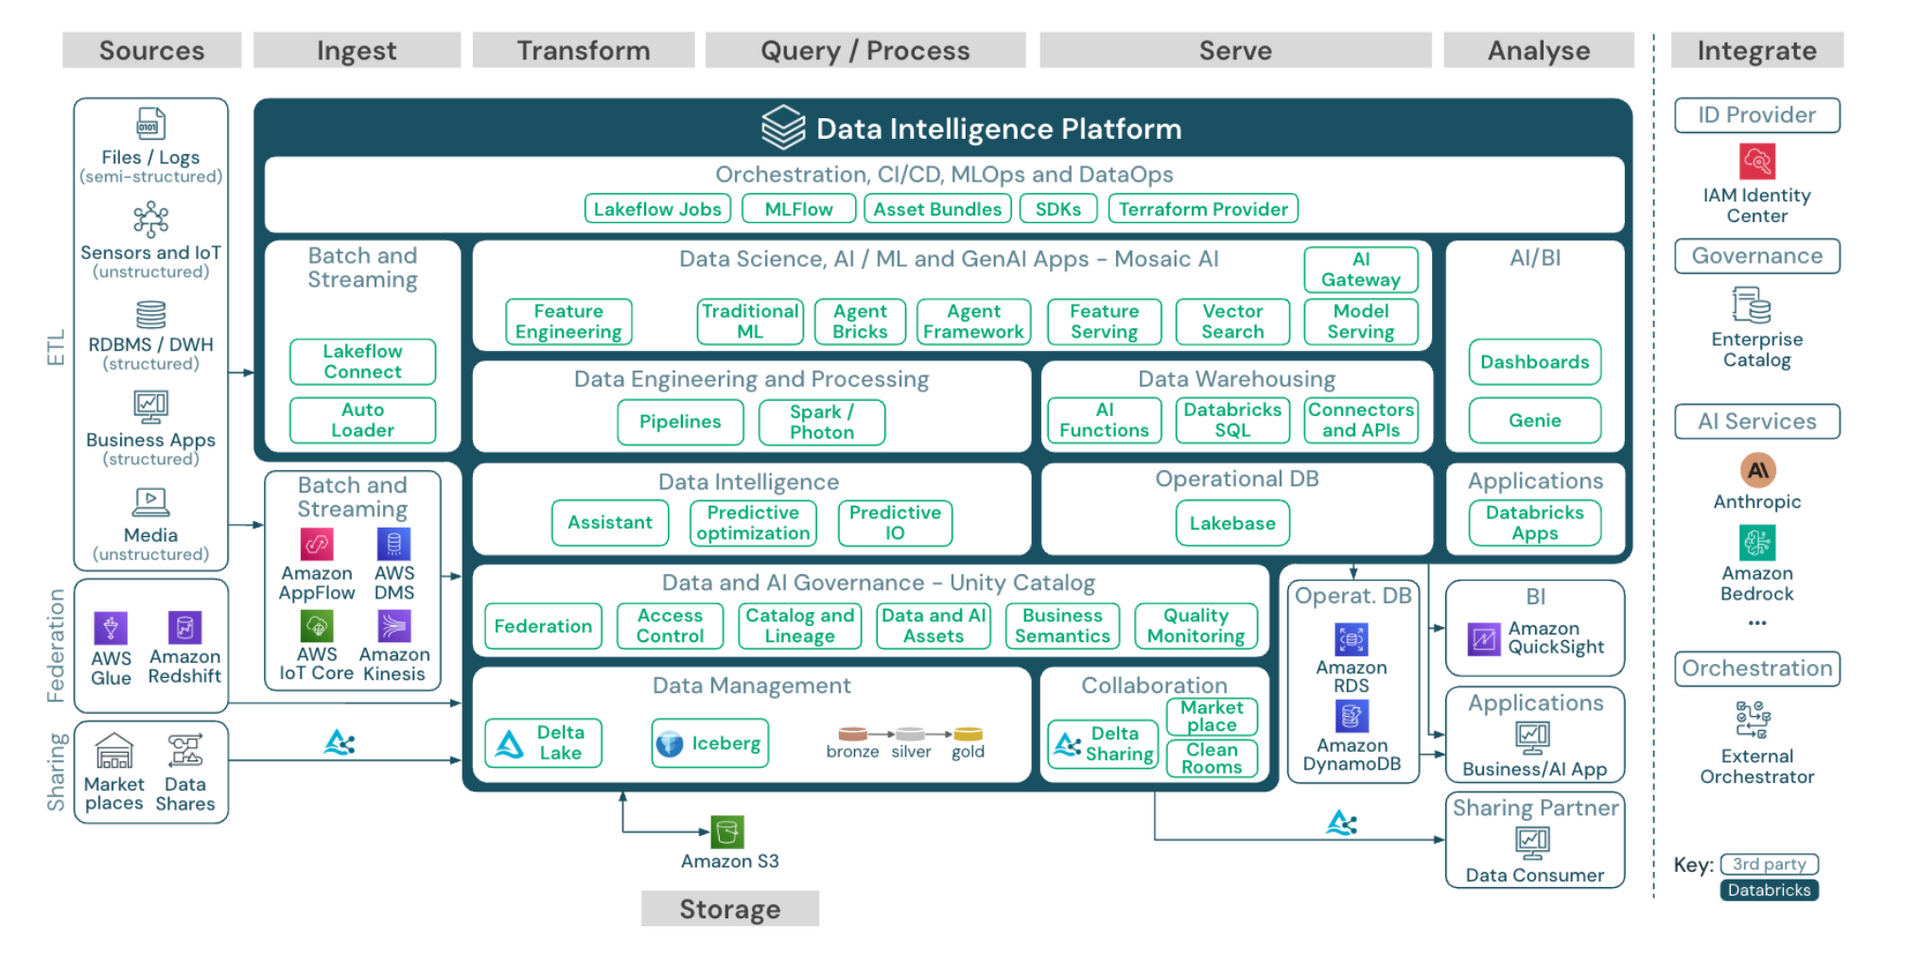
Imagem 10: Arquitetura de referência de Machine Learning Databricks
Fonte:
Databricks
Casos de uso do Databricks nas empresas
A amplitude da plataforma permite atender diferentes necessidades. Alguns dos casos mais comuns incluem:
Modernização da arquitetura de dados
Empresas com data lakes, warehouses e pipelines distribuídos podem utilizar uma arquitetura Lakehouse para consolidar workloads e reduzir movimentações desnecessárias de dados.
O objetivo é criar uma base capaz de suportar crescimento de volume, novas fontes e novos consumidores.
Business Intelligence
O Databricks pode atuar como camada de dados para iniciativas de BI, disponibilizando informações tratadas e governadas para ferramentas analíticas.
Isso é especialmente relevante quando a empresa precisa integrar múltiplas fontes antes de construir seus indicadores.
Processamento em tempo real
Em operações de logística, indústria, varejo, serviços financeiros e aplicações digitais, eventos podem precisar ser processados à medida que acontecem.
O Databricks oferece recursos para arquiteturas de streaming capazes de trabalhar com esses cenários.
Machine Learning
Modelos de previsão de demanda, recomendação, detecção de fraude, churn, manutenção preditiva e otimização podem utilizar dados processados dentro do Lakehouse.
Inteligência Artificial generativa
Dados corporativos podem alimentar aplicações de IA, agentes e experiências em linguagem natural, com mecanismos de governança e controle integrados ao ambiente.
Compartilhamento e colaboração de dados
Em ambientes com múltiplas áreas, empresas ou parceiros, também pode ser necessário compartilhar dados de forma controlada.
O ecossistema Databricks possui recursos voltados a esse tipo de colaboração, permitindo que o compartilhamento seja tratado como parte da arquitetura de dados.
Aplicações do Databricks em diferentes setores
As capacidades do Databricks podem ser aplicadas a diferentes segmentos, considerando as características dos dados, os processos e os objetivos de cada organização.
Na prática, a escolha dos casos de uso deve partir de necessidades concretas do negócio, com indicadores que permitam acompanhar os resultados da implementação.
| Setor | Possibilidades de aplicação | Indicadores que podem ser acompanhados |
|---|---|---|
| Indústria e logística | Integração de dados industriais, manutenção preditiva e análise operacional | Paradas de equipamentos, produtividade e tempo de resposta |
| Varejo e consumo | Visão integrada do cliente, previsão de demanda e recomendações | Conversão, ruptura de estoque e precisão das previsões |
| Serviços financeiros e seguros | Detecção de fraude, análise de risco e integração de dados para processos analíticos | Tempo de análise, perdas evitadas e auditabilidade |
| Telecomunicações | Análise de comportamento, previsão de churn e monitoramento de eventos | Retenção de clientes, custo de atendimento e tempo de detecção |
| Áreas corporativas | Business Intelligence, indicadores governados e aplicações de IA | Tempo de elaboração de análises, consistência das métricas e adoção das soluções |
Esses exemplos representam possibilidades de aplicação. Os resultados dependem da maturidade dos dados, da arquitetura implementada e das características de cada projeto. Por isso, definir indicadores e estabelecer uma referência inicial de desempenho são etapas importantes para avaliar os benefícios obtidos.
Databricks e otimização de custos
Uma arquitetura moderna também precisa considerar eficiência financeira.
No Databricks, os custos estão relacionados principalmente ao consumo de recursos de computação utilizados pelos diferentes workloads.
Por isso, otimização não deve acontecer apenas quando a conta cresce.
É importante observar desde o início:
- quais workloads estão consumindo recursos;
- quais clusters ou SQL warehouses estão sendo utilizados;
- quais jobs executam com maior frequência;
- quais processos podem ser otimizados;
- quais cargas precisam realmente de execução contínua;
- como os ambientes de desenvolvimento e produção estão configurados;
- como acompanhar o consumo por equipe, projeto ou workload.
Esse trabalho faz parte de uma disciplina cada vez mais importante nas arquiteturas modernas: FinOps.
No caso do Databricks, otimização pode envolver desde ajustes na arquitetura até revisão de workloads, pipelines, configurações de computação e processos de operação.
Para ambientes que estão crescendo, essa análise pode representar uma diferença significativa no custo total da plataforma.
Como avaliar o retorno de um investimento em Databricks?
Além de acompanhar o consumo da plataforma, é importante avaliar o custo total de propriedade (TCO) da arquitetura. Essa análise considera não apenas os recursos de computação utilizados pelo Databricks, mas também os custos aplicáveis de infraestrutura em nuvem, armazenamento,
movimentação de dados, integrações, operação, manutenção e capacitação das equipes.
O investimento também deve ser analisado em relação aos benefícios esperados para a organização. Dependendo do projeto, isso pode envolver:
- Redução do tempo necessário para integrar e disponibilizar novas fontes de dados;
- Diminuição do esforço de manutenção de pipelines e processos;
- Maior confiabilidade e disponibilidade das informações;
- Melhor desempenho e eficiência dos workloads;
- Redução do tempo necessário para desenvolver e colocar modelos de machine learning em produção;
- Maior autonomia das equipes no acesso e na análise dos dados.
Para avaliar o retorno sobre o investimento (ROI), é importante estabelecer indicadores antes da implementação e acompanhar sua evolução. Ganhos de produtividade, por exemplo, devem ser analisados de acordo com seus efeitos reais na operação, sem serem automaticamente tratados como redução de despesas.
Essa abordagem permite que a decisão de investimento considere tanto a viabilidade técnica quanto os resultados que a empresa pretende alcançar.
Quando faz sentido adotar Databricks na sua empresa?
A adoção do Databricks pode ser especialmente relevante para organizações que precisam modernizar sua arquitetura de dados, integrar diferentes fontes de informação ou ampliar suas iniciativas de analytics, machine learning e inteligência artificial.
Embora a plataforma reúna diversas capacidades em um mesmo ambiente, sua implementação deve considerar a estrutura tecnológica existente e os objetivos que a empresa pretende alcançar.
Alguns cenários em que vale avaliar o Databricks incluem:
1. Integração de dados de diferentes sistemas
Empresas que trabalham com informações distribuídas entre ERPs, CRMs, aplicações internas, bancos de dados e plataformas externas podem utilizar uma arquitetura Lakehouse para organizar a ingestão, o processamento e a disponibilização desses dados.
Isso é particularmente importante quando diferentes áreas precisam consumir informações consistentes, sem depender de integrações isoladas para cada necessidade.
2. Modernização de arquiteturas e pipelines de dados
Ambientes que cresceram com diferentes ferramentas, pipelines e estruturas de armazenamento podem apresentar maior complexidade de manutenção e governança.
O Databricks oferece recursos para modernizar esses processos e estruturar uma arquitetura compartilhada para engenharia de dados, analytics e inteligência artificial.
3. Expansão de analytics e Business Intelligence
Quando diferentes equipes precisam analisar grandes volumes de informação, integrar indicadores ou consultar dados com maior autonomia, uma plataforma analítica governada pode apoiar a evolução do ambiente de BI.
O Databricks pode funcionar como base para ferramentas de visualização e também oferecer recursos próprios de analytics e exploração de dados.
4. Desenvolvimento de Machine Learning e aplicações de IA
Empresas que pretendem ampliar iniciativas de modelos preditivos, IA generativa ou agentes inteligentes precisam considerar como os dados serão preparados, disponibilizados e governados.
Ao aproximar engenharia de dados, machine learning e recursos de IA, o Databricks permite desenvolver essas aplicações sobre uma arquitetura integrada.
5. Necessidade de governança e escalabilidade
À medida que o número de fontes, usuários e aplicações aumenta, também cresce a necessidade de estabelecer controles de acesso, rastreabilidade, padrões de qualidade e monitoramento.
Recursos como Unity Catalog ajudam a estruturar esses controles e a organizar a utilização dos ativos de dados e IA.
A decisão deve considerar a realidade de cada empresa
Nem todas as organizações precisam adotar uma nova plataforma ou migrar integralmente seus ambientes existentes.
Antes de investir em Databricks, é importante avaliar os workloads atuais, a infraestrutura disponível, os requisitos de segurança e governança, os custos de implementação e operação e os benefícios esperados.
Em alguns projetos, a adoção pode acontecer gradualmente, começando por um caso de uso prioritário e evoluindo conforme os resultados são validados.
Essa avaliação ajuda a definir não apenas se o Databricks faz sentido para a organização, mas também quais componentes devem ser priorizados e como planejar sua implementação.
Como avaliar uma implementação de Databricks
Uma implementação bem-sucedida começa antes da criação do primeiro workspace.
É necessário entender a arquitetura atual e estabelecer quais problemas precisam ser resolvidos.
Alguns pontos fundamentais incluem:
Fontes de dados
Quais sistemas alimentam a arquitetura?
ERP, CRM, aplicações próprias, APIs, arquivos, bancos relacionais, sistemas industriais, IoT?
Workloads
A plataforma será utilizada para:
- engenharia de dados;
- BI;
- SQL;
- streaming;
- machine learning;
- IA;
- ou uma combinação desses workloads?
Governança
Quais dados são sensíveis?
Como serão definidos acessos?
Como a empresa acompanhará linhagem e auditoria?
Ambientes
Como serão separados desenvolvimento, homologação e produção?
Como código, configurações e permissões serão promovidos entre ambientes?
Segurança
Como será estruturada a identidade?
Como funcionará o acesso à rede?
Como os dados serão protegidos?
Operação
Quem será responsável por monitorar pipelines, jobs, custos e falhas?
Escalabilidade
A arquitetura precisa suportar apenas os workloads atuais ou já deve considerar crescimento futuro?
Essas definições são importantes porque o Databricks oferece uma grande quantidade de recursos. A arquitetura precisa selecionar e organizar esses recursos de acordo com as necessidades específicas da empresa.
Como a Five Acts pode apoiar sua jornada com Databricks
A implementação do Databricks envolve decisões que vão além da configuração da plataforma. Para construir uma arquitetura consistente, é necessário compreender as fontes de dados existentes, definir os workloads prioritários, estabelecer políticas de governança e preparar o ambiente para as necessidades atuais e futuras da empresa.
A Five Acts atua com consultoria especializada em dados, engenharia, machine learning e cloud, apoiando organizações na adoção, modernização e evolução de ambientes Databricks.
Nossa atuação pode acompanhar diferentes etapas dessa jornada, de acordo com o estágio de maturidade e os objetivos de cada empresa.
1. Diagnóstico e definição da estratégia
O primeiro passo é compreender o cenário atual, identificando as fontes de dados, as tecnologias utilizadas, os processos existentes e as principais necessidades das equipes.
A partir desse diagnóstico, apoiamos a definição de prioridades, a avaliação de oportunidades de modernização e o planejamento da arquitetura.
2. Arquitetura Lakehouse e governança
Apoiamos o desenho e a implementação de arquiteturas Lakehouse, considerando a organização dos dados, a configuração dos ambientes e a definição dos componentes necessários para cada workload.
Também atuamos na estruturação do Unity Catalog, com políticas de acesso, organização dos ativos, rastreabilidade e práticas de governança alinhadas aos requisitos da empresa.
3. Engenharia e integração de dados
Desenvolvemos e modernizamos pipelines de ingestão e transformação, integrando informações de diferentes fontes e preparando os dados para consumo analítico e aplicações de inteligência artificial.
Esse trabalho pode incluir processamento batch e streaming, automação de pipelines, aplicação de regras de qualidade e padronização dos processos de engenharia.
4. Analytics, Machine Learning e IA
Com uma base de dados estruturada e governada, apoiamos a evolução das iniciativas analíticas, desde a disponibilização de informações para ferramentas de BI até o desenvolvimento de modelos preditivos e aplicações de IA generativa.
O objetivo é conectar as capacidades tecnológicas às necessidades das equipes e aos casos de uso prioritários do negócio.
5. Operação, desempenho e evolução contínua
A jornada também envolve acompanhar o desempenho dos workloads, monitorar processos e avaliar oportunidades de otimização de custos.
A Five Acts apoia a evolução do ambiente para que novas fontes, aplicações e necessidades possam ser incorporadas com planejamento, governança e eficiência operacional.
Uma jornada que acompanha as necessidades da sua empresa
Cada organização está em um momento diferente. Algumas estão avaliando sua primeira implementação de Databricks; outras já possuem ambientes em operação e precisam modernizar pipelines, fortalecer a governança ou ampliar o uso de analytics e IA.
Por isso, nossa atuação começa pela compreensão das prioridades do negócio e pela definição de um caminho de implementação adequado ao cenário de cada empresa.
Sua empresa já tem um projeto em andamento ou está avaliando novas possibilidades com Databricks?
Apresente suas prioridades à Five Acts e descubra como podemos apoiar a próxima etapa da sua arquitetura de Dados e IA.
Compartilhe